对于 Apache Iceberg 和 Delta Lake 表,修改表的每个操作都会创建新的表版本。 使用历史记录信息来审核操作、回滚表或查询特定时间点的表(使用按时间顺序查看)。
注释
不要把表历史作为数据归档的长期备份方案。 除非您已将数据和日志保留配置设置为更大的值,否则仅使用过去 7 天用于时间旅行操作。
检索表历史记录
DESCRIBE HISTORY运行该命令,检索每个写入表的操作、用户和时间戳等信息。 操作按时间倒序返回。
关于返回的 DESCRIBE HISTORY 列、列 operationParameters 中的值以及列中的 operationMetrics 每个操作指标,请参见 表历史模式和操作指标。
表历史记录保留期取决于表设置 logRetentionDuration,后者默认为 30 天。
注释
时间旅行和表历史记录由不同的保留阈值控制。 请参阅 时间旅行。
DESCRIBE HISTORY table_name       -- get the full history of the table

DESCRIBE HISTORY table_name LIMIT 1  -- get the last operation only
有关 Spark SQL 语法的详细信息,请参阅 DESCRIBE HISTORY。
有关 Scala、Java和Python语法详细信息,请参阅 Delta Lake API 文档。
目录资源管理器 在“ 历史记录 ”选项卡上直观显示表历史记录。
识别OPTIMIZE操作的类型
自动压缩、液态聚簇和 Z 排序在表的历史记录中都显示为 OPTIMIZE 操作。 若要确定运行的是哪一个,请检查 operationParameters 列。
若要对表历史记录中的每个操作进行分类 OPTIMIZE ,请运行以下命令:
SELECT
  version,
  timestamp,
  CASE
    WHEN operationParameters.clusterBy IS NOT NULL AND operationParameters.clusterBy <> '[]' THEN 'Liquid clustering'
    WHEN operationParameters.zOrderBy IS NOT NULL AND operationParameters.zOrderBy <> '[]' THEN 'Z-ordering'
    WHEN operationParameters.auto = 'true' THEN 'Auto compaction'
    ELSE 'Manual OPTIMIZE'
  END AS optimize_type,
  operationParameters.auto AS is_auto_compaction,
  operationParameters.clusterBy AS cluster_by,
  operationParameters.zOrderBy AS z_order_by,
  operationMetrics.numRemovedFiles AS files_compacted,
  operationMetrics.numAddedFiles AS files_added,
  operationMetrics.numRemovedBytes AS bytes_removed,
  operationMetrics.numAddedBytes AS bytes_added
FROM (DESCRIBE HISTORY table_name)
WHERE operation = 'OPTIMIZE'
ORDER BY version DESC;
以下各节详细介绍了每个 operationParameters 值。 关于前一查询所选择的键的定义 operationMetrics ,请参见 操作度量。
自动压缩
自动压缩会将 auto 参数设置为 true. Azure Databricks在写入后自动触发自动压缩。 当 auto 为 false 时,用户或计划任务运行了 OPTIMIZE 命令。
例如,自动压缩操作显示以下内容:
operationParameters: {
  "auto": "true"
}
有关自动压缩的详细信息,请参阅 自动压缩。
液体聚类分析
Liquid 聚类会将聚类列名称填入 clusterBy 参数。 空 clusterBy 数组 ([]) 仅指示文件压缩。
例如,按 date 列和 region 列对数据进行分组的操作会显示以下内容:
operationParameters: {
  "clusterBy": "[\"date\",\"region\"]"
}
有关液体聚类分析的详细信息,请参阅 对表使用液体聚类分析。
Z 排序
Z 排序使用 Z 顺序列名称填充 zOrderBy 参数。 空 zOrderBy 数组 ([]) 指示操作未应用 Z 排序。
例如,对 date 列应用 Z 排序的操作如下所示:
operationParameters: {
  "zOrderBy": "[\"date\"]"
}
操作范围
该 predicate 参数指示操作是在完整表上运行还是只运行其中一部分:
- 空数组
predicate([])表示该操作是在整个表上运行的。 - 填充
predicate数组表示OPTIMIZE table_name WHERE <partition_predicate>目标命令仅在与谓词匹配的分区上运行。
例如,针对分区匹配 year = 2024 的操作显示以下内容:
operationParameters: {
  "predicate": "[\"'year = 2024\"]"
}
时间旅行
时间旅行支持根据时间戳或表版本(如事务日志中记录)查询以前的表版本。 可以使用时间旅行应用于以下情况:
- 重新创建分析、报告或输出,例如机器学习模型的输出。 这对于调试或审核非常有用,尤其是在受管制行业。
- 编写复杂的时态查询。
- 修复数据中的错误。
- 为针对快速变化表的一组查询提供快照隔离。
注释
在 Databricks Runtime 18.0 及更高版本中,如果请求的版本早于 deletedFileRetentionDuration 表属性(默认 7 天),将阻止时间旅行查询。 对于 Unity 目录托管表,这适用于 Databricks Runtime 12.2 及更高版本。
时间旅行语法
通过在表名定义之后添加子句来查询支持时间旅行功能的表。
-
timestamp_expression可以是下列项中的任意一项:-
'2018-10-18T22:15:12.013Z',即可以转换为时间戳的字符串 cast('2018-10-18 13:36:32 CEST' as timestamp)-
'2018-10-18',即日期字符串 current_timestamp() - interval 12 hoursdate_sub(current_date(), 1)- 能够转换为时间戳或本身就是时间戳的任何其他表达式
-
-
version是可以从DESCRIBE HISTORY table_spec的输出中获取的 long 值。
timestamp_expression 和 version 都不能是子查询。
只接受日期或时间戳字符串。 例如,"2019-01-01" 和 "2019-01-01T00:00:00.000Z"。 有关示例语法,请参阅以下代码:
SQL
SELECT * FROM people10m TIMESTAMP AS OF '2018-10-18T22:15:12.013Z';
SELECT * FROM people10m VERSION AS OF 123;
Python
df1 = spark.read.option("timestampAsOf", "2019-01-01").table("people10m")
df2 = spark.read.option("versionAsOf", 123).table("people10m")
还可以使用 @ 语法将时间戳或版本指定为表名称的一部分。 时间戳必须采用 yyyyMMddHHmmssSSS 格式。 您可以使用 @v 指定一个版本。 有关示例语法,请参阅以下代码:
SQL
-- Timestamp version
SELECT * FROM people10m@20190101000000000
-- Version number
SELECT * FROM people10m@v123
Python
# Timestamp version
spark.read.table("people10m@20190101000000000")
# Version number
spark.read.table("people10m@v123")
为“时光旅行查询”配置数据保留
若要查询以前的表版本, 必须同时保留 该版本的日志和数据文件:
- 当
VACUUM针对某个表运行时,会删除数据文件。 - 在为表版本创建检查点后,会自动删除日志文件。
若要增加表的数据保留阈值,必须配置下表属性,并将其替换为<format>:deltaiceberg
-
<format>.logRetentionDuration = "interval <interval>":控制表的历史记录的保留时间长度。 默认值为interval 30 days。- 在 Databricks Runtime 18.0 及更高版本中,
logRetentionDuration必须大于或等于deletedFileRetentionDuration。 对于 Unity 目录托管表,这适用于 Databricks Runtime 12.2 及更高版本。
- 在 Databricks Runtime 18.0 及更高版本中,
-
<format>.deletedFileRetentionDuration = "interval <interval>":确定由VACUUM用来删除当前表版本中不再引用的数据文件的阈值。 默认值为interval 7 days。
例如,若要访问 30 天的历史数据,请设置 delta.deletedFileRetentionDuration = "interval 30 days",这与 delta.logRetentionDuration 的默认设置一致。
Important
随着维护的数据文件的增多,提高数据保留期阈值可能会导致存储成本上升。
可以在创建表期间指定表属性,也可以使用语句设置它们 ALTER TABLE 。 请参阅 表属性参考。
时间旅行示例
若要修复用户 111 对表的误删除问题,请执行以下操作:
INSERT INTO my_table
  SELECT * FROM my_table TIMESTAMP AS OF date_sub(current_date(), 1)
  WHERE userId = 111
若要修复表的意外错误更新,请:
MERGE INTO my_table target
  USING my_table TIMESTAMP AS OF date_sub(current_date(), 1) source
  ON source.userId = target.userId
  WHEN MATCHED THEN UPDATE SET *
查询上周添加的新客户数:
SELECT
(
  SELECT count(distinct userId)
  FROM my_table
)
-
(
  SELECT count(distinct userId)
  FROM my_table TIMESTAMP AS OF date_sub(current_date(), 7)
) AS new_customers
事务日志检查点
事务日志以 JSON 文件的形式记录表版本,这些文件位于事务日志目录中,并与表数据并存。
为了优化检查点查询,将各表版本聚合成 Parquet 检查点文件,这样就无需读取表历史记录中的所有 JSON 版本,从而提升性能。 用户无需直接与检查点交互。
Azure Databricks 针对数据大小和工作负荷优化检查点操作频率。 检查点频率可能会更改,恕不另行通知。
将表还原到早期状态
使用 RESTORE 命令可将表还原到先前的版本或时间戳,包括以下场景:
- 可以再次还原已经还原的表。
- 可以还原克隆的表。
请考虑以下要求:
- 若要还原表,必须具有
MODIFY该表的权限。 - 在数据文件被手动删除或由
VACUUM删除后,你将无法将表还原到引用这些文件的较早版本。 如果将spark.sql.files.ignoreMissingFiles设置为true,则仍可部分还原为此版本。 - 若要按时间戳还原,请使用格式
yyyy-MM-dd HH:mm:ss或yyyy-MM-dd。
RESTORE TABLE target_table TO VERSION AS OF <version>;
RESTORE TABLE target_table TO TIMESTAMP AS OF <timestamp>;
有关语法详细信息,请参阅 RESTORE。
流式处理行为
还原是一项数据更改操作,可能会导致下游工作负荷重复数据。 命令添加的 RESTORE 日志条目包含 dataChange 设置为 true。
对于下游工作负荷(例如处理表更新的 结构化流式处理 作业),还原操作添加的数据更改日志条目被视为新的数据更新,处理它们可能会导致重复数据。
例如:
| 表格版本 | Operation | 日志更新 | 数据变更日志更新中的记录 |
|---|---|---|---|
| 0 | INSERT |
AddFile(/path/to/file-1, dataChange = true) |
(name = Viktor, age = 29), (name = George, age = 55) |
| 1 | INSERT |
AddFile(/path/to/file-2, dataChange = true) |
(名称 = 乔治, 年龄 = 39) |
| 2 | OPTIMIZE |
AddFile(/path/to/file-3, dataChange = false), RemoveFile(/path/to/file-1), RemoveFile(/path/to/file-2) |
无记录。
OPTIMIZE 压缩不会更改表中的数据。 |
| 3 | RESTORE(version=1) |
RemoveFile(/path/to/file-3), AddFile(/path/to/file-1, dataChange = true), AddFile(/path/to/file-2, dataChange = true) |
(姓名 = Viktor, 年龄 = 29), (姓名 = George, 年龄 = 55), (姓名 = George, 年龄 = 39) |
在前面的示例中,RESTORE 命令会返回之前在读取表版本 0 和 1 时看到的那些更新。 如果流式处理查询再次读取此表,则这些文件被视为新添加的数据,并再次进行处理。
还原指标
完成后, RESTORE 将以下指标报告为单行数据帧:
table_size_after_restore:表还原后的大小。num_of_files_after_restore:还原后表中的文件数。num_removed_files:从表中删除(逻辑删除)的文件数。num_restored_files:由于回退而还原的文件数。removed_files_size:从表中删除的文件的总大小(以字节为单位)。restored_files_size:已还原的文件的总大小(以字节为单位)。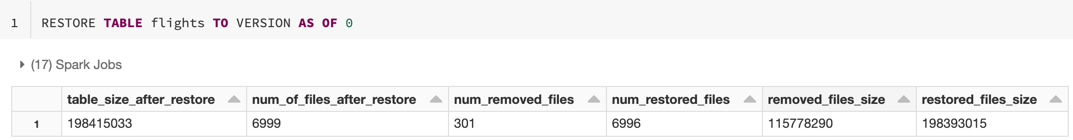
查找最后一个提交版本
在所有线程和所有表中,要获取当前 SparkSession 写入的最后一次提交的版本号,请查询 SQL 配置 spark.databricks.<format>.lastCommitVersionInSession。 根据表格的格式,将 <format> 替换为 delta 或 iceberg。
例如:
SQL
SET spark.databricks.delta.lastCommitVersionInSession
Python
spark.conf.get("spark.databricks.delta.lastCommitVersionInSession")
Scala
spark.conf.get("spark.databricks.delta.lastCommitVersionInSession")
如果 SparkSession 未进行任何提交,则查询该键时将返回空值。
注释
如果跨多个线程共享相同 SparkSession ,则类似于在多个线程之间共享变量。 在并发更新配置值时,可能会遇到竞争条件。