在数据工程中, 回填 是指通过设计用于处理当前或流数据的数据管道追溯处理历史数据的过程。
通常,这是一个将数据发送到现有表的独立数据流。 下图显示了向管道中的青铜表发送历史数据的回填流。
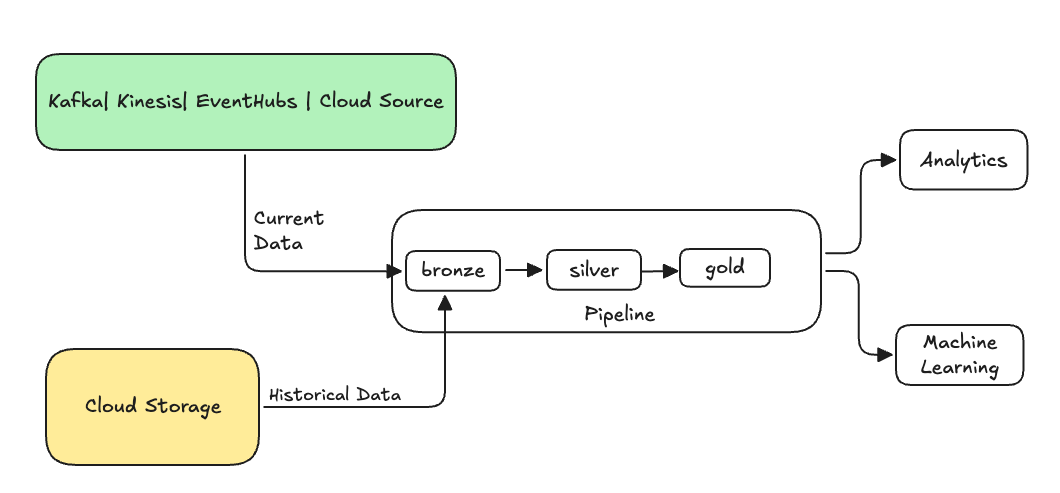
某些可能需要回填的方案:
处理旧系统的历史数据以训练机器学习(ML)模型或构建历史趋势分析仪表板。
由于上游数据源的数据质量问题,重新处理数据子集。
业务要求已更改,需要为初始管道未涵盖的不同时间段回填数据。
业务逻辑已更改,需要重新处理历史数据和当前数据。
你使用的回填流取决于目标表和源数据。 对于具有权威快照的 AUTO CDC 慢变维度(SCD)类型1目标,使用一次性 AUTO CDC FROM SNAPSHOT 流程。 对于重放历史变更的SCD迁移,请使用一次性 AUTO CDC 流程。
对于仅追加型回填:使用专门的追加流程,使用 ONCE 选项对仅追加流式表执行回填。 有关的详细信息,请参阅append_flow或ONCE。
将历史数据回填到流式处理表中时的注意事项
通常,会将数据追加到青铜流式表中。 下游的银层和金层则从青铜层接收新数据。
确保管道可以正常处理重复的数据,以防多次追加相同的数据。
确保历史数据架构与当前数据架构兼容。
考虑数据量大小和所需的处理服务水平协议(SLA),并相应配置集群和批处理大小。
示例:向现有管道添加 backfill
在此示例中,假设你有一个管道,该管道从 2025 年 1 月 1 日起从云存储源引入原始事件注册数据。 你后来意识到,你想回填过去三年的历史数据,用于下游报告和分析的用例。 所有数据位于一个位置,按年、月和日分区,采用 JSON 格式。
初始管道
这是逐步从云存储导入事件注册原始数据的管道程序代码。
Python
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
incremental_load_path = f"{source_root_path}/*/*/*"

# create a streaming table and the default flow to ingest streaming events
@dp.table(name="registration_events_raw", comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2025-01-01T00:00:00.000+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}") # safeguard to not process data before begin_year
    )
SQL
-- create a streaming table and the default flow to ingest streaming events
CREATE OR REFRESH STREAMING LIVE TABLE registration_events_raw AS
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025'; -- safeguard to not process data before begin_year
在这里,我们使用 modifiedAfter 自动加载程序选项来确保未处理云存储路径中的所有数据。 增量处理在该边界处被切断。
小窍门
其他数据源(例如 Kafka、Kinesis 和 Azure 事件中心)具有等效的读取器选项来实现相同的行为。
回填前 3 年的数据
现在,需要添加一个或多个流来回填以前的数据。 在此示例中,执行以下步骤:
使用
append once流。 这会执行一次性回填,并且不会在此一次性回填后继续运行。 代码保留在管道中,如果管道已完全刷新,则重新运行回填。创建三个回填流,每个流对应一年(在此示例中,数据按年份在路径中拆分)。 对于 Python,我们将流创建参数化,但在 SQL 中,我们为每个流重复三次代码。
如果您正在处理自己的项目,并且不使用无服务器计算,则可能需要更新流水线的最大工作线程。 增加最大工作者可确保有资源来处理历史数据,同时继续在预期服务级别协议内处理当前流数据。
小窍门
如果使用具有增强的自动缩放(默认值)的无服务器计算,则当负载增加时,群集会自动增加大小。
Python
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
backfill_years = spark.conf.get("backfill_years") # e.g. "2024,2023,2022"
incremental_load_path = f"{source_root_path}/*/*/*"

# meta programming to create append once flow for a given year (called later)
def setup_backfill_flow(year):
    backfill_path = f"{source_root_path}/year={year}/*/*"
    @dp.append_flow(
        target="registration_events_raw",
        once=True,
        name=f"flow_registration_events_raw_backfill_{year}",
        comment=f"Backfill {year} Raw registration events")
    def backfill():
        return (
            spark
            .read
            .format("json")
            .option("inferSchema", "true")
            .load(backfill_path)
        )

# create the streaming table
dp.create_streaming_table(name="registration_events_raw", comment="Raw registration events")

# append the original incremental, streaming flow
@dp.append_flow(
        target="registration_events_raw",
        name="flow_registration_events_raw_incremental",
        comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2024-12-31T23:59:59.999+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}")
    )

# parallelize one time multi years backfill for faster processing
# split backfill_years into array
for year in backfill_years.split(","):
    setup_backfill_flow(year) # call the previously defined append_flow for each year
SQL
-- create the streaming table
CREATE OR REFRESH STREAMING TABLE registration_events_raw;

-- append the original incremental, streaming flow
CREATE FLOW
  registration_events_raw_incremental
AS INSERT INTO
  registration_events_raw BY NAME
SELECT * FROM STREAM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025';

-- one time backfill 2024
CREATE FLOW
  registration_events_raw_backfill_2024
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2024/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2023
CREATE FLOW
  registration_events_raw_backfill_2023
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2023/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2022
CREATE FLOW
  registration_events_raw_backfill_2022
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2022/*/*",
  format => "json",
  inferColumnTypes => true
);
此实现重点介绍了几个重要的模式。
关注点分离
增量处理与回填操作相互独立。
每个流都有自己的配置和优化设置。
增量和回填操作之间有明显的区别。
受控执行
使用
ONCE选项可确保每个回填准确运行一次。回填流保留在管道图中,但在完成后会处于空闲状态。 它已准备好在完全刷新时自动使用。
在管道定义中有回填操作的明确审计记录。
处理优化
可以将大型回填拆分为多个较小的回填,以便更快地处理或控制处理。
使用增强的自动缩放根据当前群集负载动态缩放群集大小。
架构演变
使用
schemaEvolutionMode="addNewColumns"优雅地处理架构更改。跨历史数据和当前数据具有一致的模式推断。
对较新的数据中的新列进行安全处理。
向 AUTO CDC SCD 类型 1 表添加回填
使用一次性 AUTO CDC FROM SNAPSHOT 流程向同时接收持续变更数据捕获(CDC)流的SCD类型1目标添加权威快照。 快照版本和 CDC 排序列构成一个排序域。 较新的CDC事件优先于旧快照,而较新的快照优先于旧CDC事件。
Requirements
在添加回填之前,确保流满足以下要求:
目标使用 SCD 1 型。
目标仅有一个
AUTO CDC FROM SNAPSHOT流和一个或多个名称唯一的AUTO CDC流。所有流程使用相同数量的键,顺序相同。 快照流键名与
AUTO CDC键名比较时不区分大小写。 多个AUTO CDC流程必须使用相同的密钥名和大小写。快照版本和每个CDC序列列的数据类型完全相同。
AUTO CDC FROM SNAPSHOT流程并不定义期望。AUTO CDC流不使用IGNORE NULL UPDATES。 在 Python 中,不要设置ignore_null_updates、ignore_null_updates_column_list或ignore_null_updates_except_column_list。该管道使用触发模式。 该模式不支持连续管道。
这两种流类型都可以使用SQL或Python流水线接口。 你可以在同一个目标中混合使用SQL和Python流程。
快照必须表示源在该版本中的完整状态。 如果目标键在快照中不存在,AUTO CDC FROM SNAPSHOT 则将这种不存在视为快照版本中的删除。 带有较新版本的 CDC 事件会保留或恢复该密钥。
添加回填
要添加一次性快照回填并继续处理CDC事件,请使用以下步骤:
在流水线定义中保留现有的目标表及其正在进行的
AUTO CDC流。定义权威快照及其版本。 对于 Python 回调,第一次调用必须返回快照和版本。 只有在处理至少一个快照后才返回
None。添加一个
ONCE流程,使用 Python 中的AUTO CDC FROM SNAPSHOT或 SQL 中的once=True。 对于对现有目标进行SQL回填,包含WITH VERSION查询。 没有WITH VERSION的SQL快照流只支持对空目标的初始加载。运行一次触发的管道更新,以处理回填和正在进行的 CDC 事件。
以下示例从一个现有的 Python 流水线开始,该流水线逐步处理来自 customers_cdc的变更。 假设你已经运行了这条流水线并填充了 customers 目标:
from pyspark import pipelines as dp
from pyspark.sql.functions import col, expr

@dp.view
def customers_cdc():
    return (
        spark.readStream.table("main.bronze.customers_cdc")
        .withColumn("change_timestamp", col("change_timestamp").cast("timestamp"))
    )

dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name="customers_incremental_cdc",
    target="customers",
    source="customers_cdc",
    keys=["customer_id"],
    sequence_by=col("change_timestamp"),
    apply_as_deletes=expr("operation = 'DELETE'"),
    except_column_list=["operation", "change_timestamp"],
    stored_as_scd_type=1,
)
为了使用截至2025年1月1日的 customers_snapshot 状态回填该现有目标,请将以下代码添加到同一流水线定义中。 保持现有目标表和 AUTO CDC 流程:
from datetime import datetime, timezone
from typing import Optional, Tuple

from pyspark.sql import DataFrame

backfill_version = datetime(2025, 1, 1, tzinfo=timezone.utc)

def backfill_snapshot_and_version(
    latest_snapshot_version: Optional[datetime],
) -> Optional[Tuple[DataFrame, datetime]]:
    if latest_snapshot_version is None:
        return (spark.read.table("main.legacy.customers_snapshot"), backfill_version)
    return None

dp.create_auto_cdc_from_snapshot_flow(
    target="customers",
    source=backfill_snapshot_and_version,
    keys=["customer_id"],
    stored_as_scd_type=1,
    once=True,
)
回调必须在首次调用时返回快照和版本。 如果在处理任何快照之前返回 None ,流水线更新将失败。 快照处理完成后,返回 None 表示没有更多可用的快照。
该快照是一个 Python datetime,对应于 Spark SQL TIMESTAMP 类型。 现有 AUTO CDC 流会将 change_timestamp 转换为 TIMESTAMP,使两种序列类型完全匹配。 示例中两种流程都用 Python,但你可以用 SQL 定义任一流程,同时在同一目标中混合 SQL 和 Python 流程。 关于 SQL 语法,包括目标非空时所需的WITH VERSION查询,请参见CREATE FLOW (pipelines)。
快照流成功提交后,后续的增量更新会跳过该快照流,同时流程 AUTO CDC 继续处理新事件。
Important
目标的全面刷新会重新运行一次性快照流程。 在进行全面刷新前,保持快照可用并确保它仍代表预期状态。
该统一回填模式不支持SCD Type 2或双时态目标。
示例:迁移过程中回填SCD目标
一种常见的迁移场景是:遗留系统中已经存在一张缓慢变化维度(SCD)表,并且积累了多年的历史数据,但其原始变更馈送已不再可用。 因为原有的变更事件已经消失,你需要将遗留表自身的历史一次性重放到新的 AUTO CDC 目标中,然后为后续变更附加新的 CDC 数据流。 有关 AUTO CDC 和 SCD 类型的更多信息,请参见 《AUTO CDC API:通过管道简化变更数据捕获》。
该模式是一次性执行的 AUTO CDC 流,写入与持续进行的 AUTO CDC 流所针对的同一个流表。
AUTO CDC目标只接受AUTO CDC流,因此种子也必须是AUTO CDC流。 向同一张表追加普通 INSERT INTO ONCE 流未通过验证:
创建
AUTO CDC流将写入的目标流式表。AUTO CDC ONCE,使用一个流将遗留 SCD 表作为流读取,并按遗留有效性起始列排序。 把传承的顺序当作变革事件来重玩,而不是自己塑造它们。AUTO CDC为 SCD 类型 2 目标构建__START_AT和__END_AT历史记录列,因此不要直接写入这些列。附加正在读取最新
AUTO CDC变更馈送的流AUTO CDC按每个键分别确定顺序,因此切换时必须对每个业务键分别满足这一要求:每个键的首次实时变更都必须排在该键最后一次预置变更之后。 仅仅晚于全局遗留最大值的序列值,对于单个键来说仍可能过时,该键的首次有效变更会被忽略或顺序错误。
以下代码创建了一个使用上述步骤的流式表:
CREATE OR REFRESH STREAMING TABLE customers_history;

-- One-time seed: replay the legacy history as change events
CREATE FLOW customers_history_seed
AS AUTO CDC ONCE INTO customers_history
FROM stream(legacy.customers_scd2)
KEYS (customer_id)
SEQUENCE BY valid_from
STORED AS SCD TYPE 2;

-- Ongoing live CDC into the same target
CREATE FLOW customers_history_cdc
AS AUTO CDC INTO customers_history
FROM stream(customers_cdc_bronze)
KEYS (customer_id)
SEQUENCE BY change_timestamp
STORED AS SCD TYPE 2;
两个流程必须在键、SCD类型以及序列列的数据类型上达成一致。 在前面的示例中,两个流程都以时间戳为序,并使用单一的切换时刻将预置的历史数据与实时数据流分开。 如果遗留表的序列类型与实时数据源不同,可以投射其中一个表,使类型匹配。
同样的模式也适用于 SCD 1 型目标表:将两个流中的 STORED AS SCD TYPE 2 都改为 STORED AS SCD TYPE 1,目标表就只保留每个键的当前行。 在依赖任一形状之前,先验证一组密钥样本,确认种子密钥的首次实时更改只产生一个新版本,并且正确关闭了之前的版本。 通常在这一步会出现每个键的序列空档。