特征表可以通过两种方式提供:
- 模型服务:部署一个在特征表上训练过的模型。 同一端点用于特征查找和模型推断。
-
功能服务:部署一个直接引用特征表的
FeatureSpec,无需模型。 端点返回请求的功能输出。 当应用程序需要特征值而不是模型预测时,请使用此功能。 如果你最终用特征进行模型推断,Databricks建议直接使用模型服务。
这两种方法都支持预计算和按需功能。
要求
Databricks Runtime 14.2 ML 或更高版本。
若要使用 Python API,功能服务需要
databricks-feature-engineering版本 0.1.2 或更高版本,该版本内置于 Databricks Runtime 14.2 ML 中。 对于早期 Databricks Runtime ML 版本,请使用%pip install databricks-feature-engineering>=0.1.2手动安装所需的版本。 如果使用 Databricks 笔记本,则必须通过在新单元格中运行以下命令来重启 Python 内核:dbutils.library.restartPython()。若要使用 Databricks SDK,功能服务需要
databricks-sdk0.18.0 或更高版本。 若要手动安装所需的版本,请使用%pip install databricks-sdk>=0.18.0。 如果使用 Databricks 笔记本,则必须通过在新单元格中运行以下命令来重启 Python 内核:dbutils.library.restartPython()。
Databricks 功能服务提供了一个 UI 和多个编程选项,用于创建、更新、查询和删除终结点。 本文包括以下每个选项的说明:
Databricks 用户界面
REST API
Python API
Databricks SDK
若要使用 REST API 或 MLflow 部署 SDK,必须具有 Databricks API 令牌。
重要
作为适用于生产场景的安全最佳做法,Databricks 建议在生产期间使用计算机到计算机 OAuth 令牌来进行身份验证。
对于测试和开发,Databricks 建议使用属于服务主体(而不是工作区用户)的个人访问令牌。 若要为服务主体创建令牌,请参阅管理服务主体的令牌。
功能服务的身份验证
有关身份验证的信息,请参阅 授权访问 Azure Databricks 资源。
创建 FeatureSpec
FeatureSpec 是用户定义的一组功能和函数。 可以在一个 FeatureSpec 中合并功能和函数。
FeatureSpecs 由 Unity 目录储存和管理,并显示在目录资源管理器中。
必须将 FeatureSpec 中指定的表发布到在线功能商店或第三方在线商店。
必须使用 databricks-feature-engineering 包来创建 FeatureSpec。
首先,定义函数:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
然后,可以在FeatureSpec中使用该函数。
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
指定默认值
若要指定功能的默认值,请使用 default_values .. 中的 FeatureLookup参数。 请参阅以下示例:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
如果使用 rename_outputs 参数重命名特征列,则 default_values 必须使用重命名后的特征名称。
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
添加Python依赖项
如果用户定义的函数(UDF)导入 Python 包,请在创建 FeatureSpec 时声明这些包。 该 extra_pip_requirements 参数需要 databricks-feature-engineering 版本 0.17.0 或更高版本。 特征服务会自动安装 MLflow 和 databricks-feature-lookup 软件包。
例如,如果你的功能规范中的一个 UDF 导入了 NumPy,可以在规范中添加以下要求:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
在main.default.customer_features_with_dependencies时,使用作为规范名称。
extra_pip_requirements 中的每个条目都必须是 PyPI 依赖项字符串(例如 numpy==1.26.4),或者是 Unity Catalog 卷中 .whl 文件的路径。 例如,对于你已上传的车轮,请使用 /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl。 端点创建者必须在卷上拥有 USE CATALOG,并在其父目录和架构上拥有 USE SCHEMA 和 READ VOLUME。
对于来自私有仓库的包,配置 工作空间默认包仓库。 不要将 pip 命令选项(例如 --index-url)放在 extra_pip_requirements 中。
Unity Catalog UDF ENVIRONMENT 中的依赖适用于离线 SQL 执行。 功能服务不会自动复制这些内容。 在功能规范要求中声明所有UDF所需的包,包括上游特征中的UDF。
关于带有 CustomUDF 和 FeatureViewSource的示例,请参见 Serve CustomUDF 特征及其依赖关系。 关于模型服务依赖,请参见 自定义UDF依赖。
创建终结点
FeatureSpec 定义了终结点。 有关详细信息,请参阅 Python API 文档或 Databricks SDK 文档。
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
Python API
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST API
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
若要查看终结点,请单击 Databricks UI 左侧边栏中的“服务”。 当状态为“就绪”时,终结点可以响应查询。
在推理表中保存扩充的数据帧
对于从 2025 年 2 月开始创建的终结点,可以将模型服务终结点配置为记录包含查找特征值和函数返回值的扩充数据帧。 DataFrame 将保存到服务模型的推断表中。
获取端点
可以使用 Databricks SDK 或 Python API 获取终结点的元数据和状态。
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
Python API
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
查询端点
可以使用 REST API、MLflow 部署 SDK 或服务 UI 查询终结点。
以下代码展示了如何在使用 MLflow 部署 SDK 时设置凭据并创建客户端。
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
注意
作为安全最佳做法,在使用自动化工具、系统、脚本和应用进行身份验证时,Databricks 建议使用属于服务主体(而不是工作区用户)的个人访问令牌。 若要为服务主体创建令牌,请参阅管理服务主体的令牌。
使用 API 查询终结点
本部分包括使用 REST API 或 MLflow 部署 SDK 查询终结点的示例。
MLflow 部署 SDK
重要
以下示例使用来自 predict() 的 API。 此 API 是实验性的,API 定义可能会发生变化。
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST API
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
使用 UI 查询终结点
可以直接从服务 UI 查询服务终结点。 UI 包含可用于查询终结点的生成的代码示例。
在 Azure Databricks 工作区的左侧导航栏中,单击“服务”。
单击要查询的终结点。
在屏幕右上角,单击“查询终结点”。
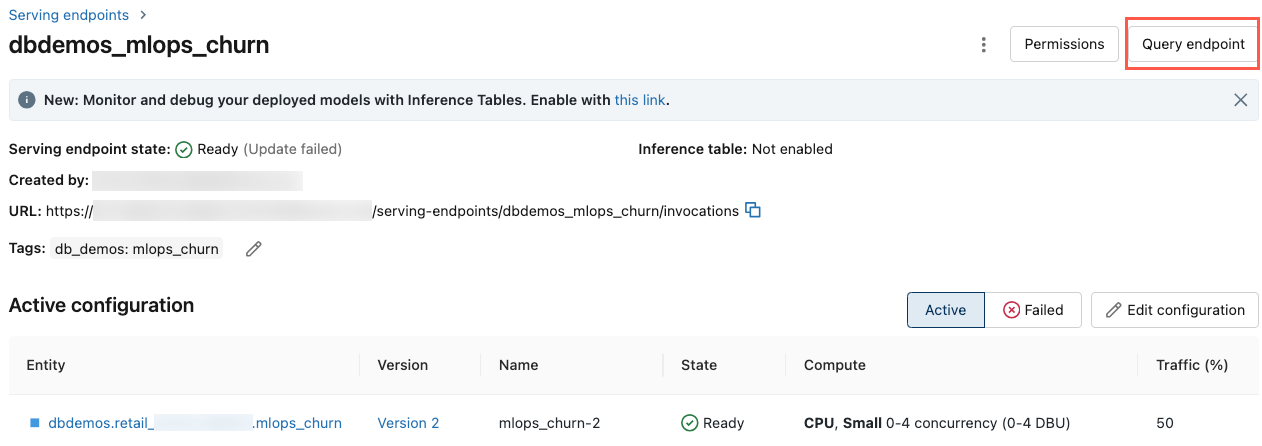
在“请求”框中,键入 JSON 格式的请求正文。
单击“发送请求”。
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
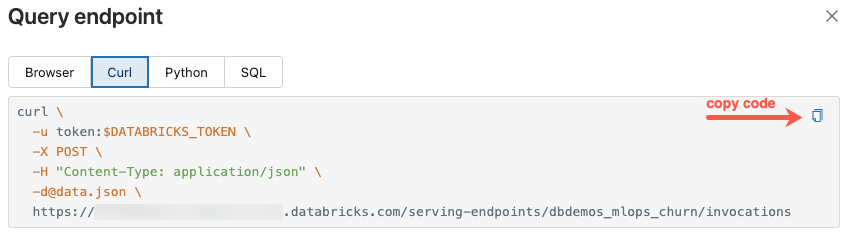
“查询终结点”对话框包含用 curl、Python 和 SQL 生成的示例代码。 单击选项卡查看并复制示例代码。
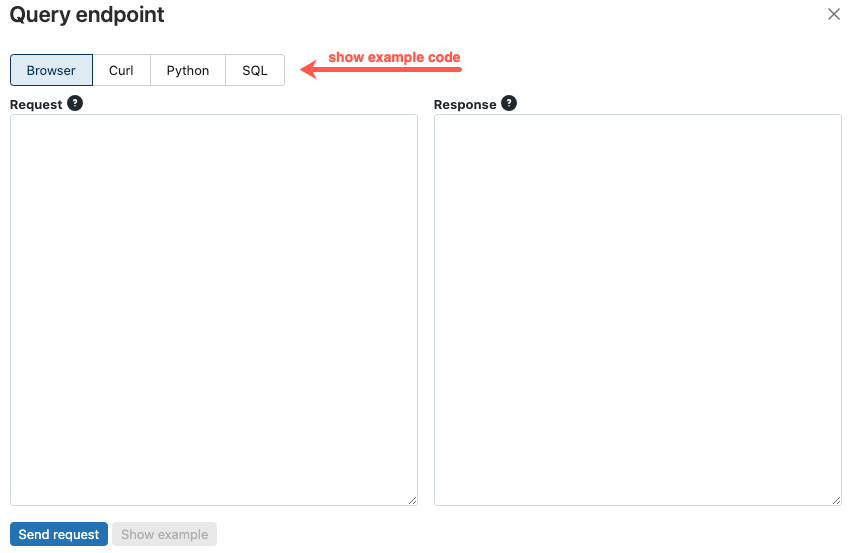
若要复制代码,请单击文本框右上角的复制图标。
更新端点
重要
若要修改功能服务终结点的配置(如更改 FeatureSpec 或工作负荷大小),请始终使用本节中所述的更新 API。 请勿删除并重新创建终结点以应用更改。 删除一个正在运行的终结点会立即引起停机,并中断所有查询它的应用程序。
可以使用 REST API、Databricks SDK 或服务 UI 更新终结点。
使用 API 更新终结点
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST API
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
使用 UI 更新终结点
按照以下步骤使用服务 UI:
在 Azure Databricks 工作区的左侧导航栏中,单击“服务”。
在表中,单击要更新的终结点的名称。 端点屏幕出现了。
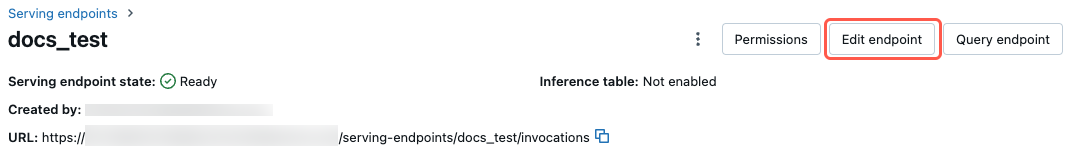
在屏幕右上角,单击“编辑终结点”。
在编辑服务终结点对话框中,根据需要编辑终结点设置。
单击“更新”以保存更改。
更新实时功能服务终结点的依赖项
功能服务端点在首次构建和部署时会解析其依赖关系:其服务主体读取在线表(USE CATALOG、USE SCHEMA和SELECT)所需的权限,以及其 FeatureSpec 中描述的 Unity Catalog UDF 上的 EXECUTE。 端点在构建时确定这些权限,不会在简单的重新部署或重启时重新解析它们。 如果你重新创建在线表或UDF,端点会失去对它的权限。 如果你在原地更新UDF,端点会继续运行原始版本。 功能查找可能会失败,或者静默使用旧的UDF逻辑,即使端点仍在报告 “准备好”。
对于在线表和按需UDFs,Databricks建议进行版本化迁移:创建依赖的新版本,针对其创建新端点,并将流量迁移到新端点。 这有助于避免停机和本节描述的故障模式。
重新创建在线表格
警告
不要在正在运行的 Feature Serving 端点下原位删除并重新创建在线表。
当你创建端点时,模型服务会向端点的服务主体授予在线表的目录上的 USE SCHEMA、其架构上的 SELECT 以及在线表上的 USE CATALOG。 删除并重新创建表,即使名称相同,也会在 Unity Catalog 中创建一个新的可保护对象,因此 SELECT 授权不会被继承。 服务主体标识失去对表的访问,OAuth 令牌生成失败,在线商店连接退回到密码认证并失败。 随后,特征查找会失败,并出现诸如 KeyError: 'OAUTH_TOKEN' 或 password authentication failed 之类的错误。
这些失败很容易被忽略:端点仍然报告 Ready,同步流水线仍显示成功运行,而查找失败。 更改在线表格的同步模式(例如,在 SNAPSHOT 和 CONTINUOUS 之间)无法原地完成,需要重新创建表格,这也可能引发这个问题。
端点不读取特定的在线表。 它通过其 FeatureSpec中命名的离线特征表查找特征,当一个特征表发布到多个在线表时,端点会使用最早的那个。 将相同的特征表发布到第二个在线表并不会将端点迁移到新的在线表。
为了减少停机时间,请同时对离线功能表和在线表进行版本控制:
创建一个新的离线要素表,并在名称中包含版本(例如,
customer_features_v2)。将新功能表发布到新的在线表。
创建一个使用新功能表的新
FeatureSpec,并创建一个为其提供服务的新功能服务端点。将流量迁移到新的端点。 当旧端点不再接收流量后,删除它及其在线表。
更新按需UDF
警告
不要就地修改被 FeatureSpec 使用的 Unity Catalog UDF。
FeatureSpec 的按需 UDF 在部署时内置到服务端点中。 普通刷新或重新部署会复用该服务映像中的同一 UDF。 同名的UDF原地更新不会生效。 如果你删除并重新创建 UDF,端点也会失去其上的 EXECUTE,所以使用 UDF 的查找会失败。
FeatureSpecs 和 UDF 没有版本字段,因此通过名称进行版本管理:创建一个新的 UDF 和一个新的 FeatureSpec,创建一个使用新 FeatureSpec 的端点,并将流量迁移到那里。 参见 创建一个 FeatureSpec。
参见 按需特征计算。
在原地变更后恢复端点
如果你已经在原处更改了依赖,重建端点使其重新解析依赖关系。 创建一个新的 FeatureSpec(或对于模型服务端点,注册一个新的模型版本),并更新该端点以提供该模型/版本服务。 更改端点所服务的内容会重建端点,这会预配新的服务主体并重新运行权限设置。 这些方法都无法可靠地重建端点:停止和启动、简单的重新部署,或更改环境变量。
删除终结点
警告
此操作不可逆。 删除功能服务终结点会导致查询该功能的任何应用程序立即停机。 如果要更改终结点的配置,请使用 更新终结点 ,而不是删除和重新创建终结点。
可以使用 REST API、Databricks SDK 或服务 UI 删除终结点。
使用 API 删除终结点
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
Python API
fe.delete_feature_serving_endpoint(name="customer-features")
REST API
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
使用 UI 删除终结点
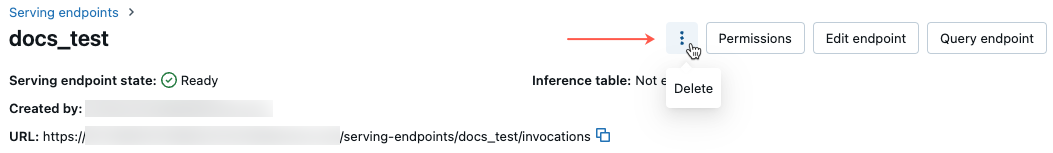
使用以下步骤通过服务 UI 删除一个终结点:
在 Azure Databricks 工作区的左侧导航栏中,单击“服务”。
在表中,单击要删除的终结点的名称。 端点屏幕出现了。
在屏幕右上角,单击烤肉串
 然后选择“ 删除”。
示例笔记本
此笔记本展示如何使用 Databricks SDK 通过 Databricks Online 功能存储创建功能服务端点。