本文介绍如何使用 Cilium 收集在 Azure Kubernetes 服务 (AKS) 上所选工作负荷的网络指标。 首先筛选一个应用程序的流指标,生成测试流量,并检查结果。 然后使用其他示例筛选特定指标类型或启用其他指标。
使用名为 ContainerNetworkMetric 的 Kubernetes 资源配置筛选。
此资源将指标集合设置存储在群集中。 您在 YAML 文件中定义设置,并使用 kubectl 应用该文件。 它控制哪些流量对指标造成影响;它不允许或阻止网络流量。
可以单独筛选 DNS、TCP、HTTP、流量和丢弃指标。 还可以启用可选的外部和目标端口指标。 以下部分介绍了这些设置,并演示如何应用这些设置。
在第一个演练结束时,你有一个应用程序的筛选器,以及其流计数器的前后检查。 可选示例仅在需要时添加详细信息;但完成演练并不需要这些示例。
Important
指标设置在整个群集中共享。 备份现有资源并保留其他团队的条目。 添加更高基数指标会增加收集成本。 删除筛选器还可以扩大采集范围。
先决条件
- 启用了 Cilium 数据平面、Kubernetes 1.32 或更高版本以及 高级容器网络服务 的 AKS 群集。 如果您需要设置集群或仍然需要设置指标收集,请先完成 设置容器网络指标收集。
- 一个 Prometheus 后端,用于收集群集的指标以及查询它的权限。 在测试筛选之前,Collection 必须正常工作。
- Bash、
kubectl以及对群集的访问权限。 可以使用本地终端。 - 读取、创建和更新群集范围
ContainerNetworkMetric资源的权限,以及运行测试 Pod 中的命令的权限。 - 一个现有且正在运行的 Linux Pod,带有
curl,位于可用于测试的命名空间中。 必须允许 Pod 连接到所选的测试目标。 以下步骤不会创建工作负荷或更改网络策略。 - 对于 Azure CLI 设置,需要版本 2.85.0 或更高版本,以及
aks-preview扩展版本 20.0.0b4 或更高版本。 使用az extension show --name aks-preview和az --version检查这些版本。 有关安装说明,请参阅 安装 Azure CLI。 若要安装或更新扩展,请使用az extension add --name aks-preview或az extension update --name aks-preview。
基本流指标示例不需要 DNS 或 HTTP 检查。 这些要求通过特定于协议的示例进行说明。
连接至群集
如果kubectl已连接到正确的群集,请跳过本节中的Azure CLI命令。 否则,请登录 az login,选择订阅,并设置现有资源组和群集的名称:
az account set --subscription "<subscription-id>"
RESOURCE_GROUP="<resource-group-name>"
CLUSTER_NAME="<cluster-name>"
az aks get-credentials --resource-group "$RESOURCE_GROUP" --name "$CLUSTER_NAME"
确认当前群集并检查它是否支持指标筛选:
kubectl config current-context
kubectl explain containernetworkmetric.spec.filters
kubectl explain containernetworkmetric.spec.filters.metric
如果上下文不是预期的群集,或者任一 API 检查失败,请停止。 在继续操作之前,请解决连接、权限或功能可用性问题。 已安装的架构描述必须支持您使用的字段和指标名称。 如果仍不起作用,请检查支持的 AKS/ACNS 版本或联系支持人员。 不要将开发 CRD 安装到托管群集中。
配置指标摄取
在开始演练之前,请在监视后端中允许其指标。 可以在代理上启用指标,而无需由 Prometheus 摄取该指标。
Azure Monitor Prometheus 的托管服务从默认引入中排除以下指标,因为它们的基数较高。 若要引入它们,请更新 kube-system 中 ama-metrics-settings-configmap ConfigMap 里的 networkobservabilityHubble 允许列表。
| Metric | 代理配置 | 托管 Prometheus 摄取 |
|---|---|---|
hubble_flows_processed_total |
基线流指标。
使用 CNM 中的一个flow条目来筛选其观察结果。 |
添加到第一个演练的允许列表。 |
hubble_flows_to_world_total |
如果服务尚未启用该项,请通过flows-to-world条目启用它。 |
使用外部目标示例时添加到允许列表。 |
hubble_port_distribution_total |
如果服务尚未启用该项,请通过port-distribution条目启用它。 |
使用目标端口示例时添加到允许列表。 |
对于第一个演练,请仅添加 hubble_flows_processed_total,保留任何现有的允许列表条目。 若要备份、更新和应用 ConfigMap 设置,请参阅 “允许托管 Prometheus 中的指标系列”。
添加 CNM 筛选器不会更新此 ConfigMap。 仅在需要时才添加其他指标名称;采集这些指标会增加时序数据量和成本。
如果使用自己的 Prometheus 部署,请改为检查其抓取和指标保留规则。 若要了解详细信息,请参阅 “允许自己的 Prometheus 中的指标系列”。
为工作负载配置采集
资源 ContainerNetworkMetric 是群集的单个共享配置。
container-network-metric设置为 metadata.name ,完全如以下示例所示。 Kubernetes 需要此名称。 可以选择 YAML 文件的任何名称。 在该文件中:
-
spec.filters列出要配置的指标。 -
metric标识指标类型,例如dns或tcp。 -
includeFilters选择要针对该指标进行计数的流量。 -
excludeFilters选择不计入该指标的流量。
从包含筛选器开始,选择所需的应用程序流量。 仅当想要省略所选内容的子集时,才添加排除筛选器。 如果要保留较大的集合,但删除特定观测数据,请使用仅排除筛选器。 排除项不是必需的,但它们在存在时优先。
例如,若要收集应用程序的 DNS 指标,请在应用程序的筛选器中添加一个 dns 条目并选择应用程序的 Pod。 这会更改 DNS 指标收集而不更改 TCP 或其他指标类型,前提是保留其现有条目。 此资源筛选 Hubble 指标;它不是群集导出的每个节点级指标的筛选器。
对于第一个配置,请从头到尾按照下面的应用程序示例进行操作。 之后,请选择另一个任务:
| Task | 配置 |
|---|---|
| 筛选客户端的 DNS 请求和答复 | 与源和目标筛选器一起使用 dns 。 请参阅 “选择 DNS 请求和响应”。 |
| 按工作负荷筛选 TCP 指标 | 将 tcp 与 Pod 或标签选择器一起使用。 请参阅 按标签选择工作负荷。 |
| 筛选应用程序的 HTTP 指标 | 将 httpV2 与工作负载筛选器配合使用。 请参阅 为应用程序选择 HTTP 观察值。 |
| 按标识筛选现有指标 | 请参阅 按安全标识筛选流指标。 |
| 从丢弃指标中排除工作负载 | 使用 drop 和排除筛选器。 请参阅 从丢弃指标中排除工作负荷。 |
| 查看指标中的外部目标 IP 地址 | 请参阅 检查到外部目标的 TCP 流量。 |
| 查看指标中的目标端口 | 请参阅 “检查目标端口”。 |
筛选器选择哪些流量对每个指标造成影响。 它们不会更改指标的标签,例如源 Pod 或目标 IP。
单独的指标条目是独立的。 如果从资源中省略服务提供的指标,它将保持启用状态,而不会针对该指标使用 CNM 筛选器。 资源不是群集可以收集的每个指标的允许列表。
当服务已为您的群集启用这些指标时,您可以筛选 dns、httpV2、tcp、flow 和 drop。 配置筛选器并不能说明工作负荷正在为该指标生成观察值。 DNS 观测需要有 DNS 检查策略和 DNS 流量。 HTTP 观察要求启用 L7、应用于工作负荷的 HTTP 检查策略,以及通过该策略的 HTTP 流量。 资源的筛选器状态并不能证明这些策略和流量先决条件已满足。 添加筛选器不会启用检查功能。
对于 HTTP 指标,区分大小写的配置名称是 httpV2,不是 http。
该 metric 字段用于选择要筛选的指标。 可选protocol字段将流量限制为tcp、udp或者dns;不接受http。
选择测试工作负载
在 Bash 终端中,用于以下命令,设置这些值。
替换 Pod 名称和 URL。 如果使用其他命名空间,请更改production。
将 POD_PREFIX 设置为应用程序的 Pod 名称的开头,并选择名称以该前缀开头的正在运行的 CLIENT_POD。 例如,checkout- 与 payments-7f6d8b9c5-x2abc 匹配,但与 checkout-7f6d8b9c5-x2abc 不匹配。
NAMESPACE="production"
POD_PREFIX="checkout-"
CLIENT_POD="<running-pod-with-curl>"
TEST_URL="https://<approved-host>/"
kubectl get pod -n "$NAMESPACE" "$CLIENT_POD" -o wide
kubectl exec -n "$NAMESPACE" "$CLIENT_POD" -- curl --version
确认 Pod 正在运行且 curl 可用。 对于包含多个容器的 Pod,请将 -c <container-name> 添加到每个 kubectl exec 命令中。
使此终端保持打开状态,使变量保持可用。
检查现有配置
在进行更改之前读取当前配置:
kubectl get containernetworkmetric container-network-metric -o yaml
如果命令返回 NotFound,请使用 新资源说明。
对于任何其他错误,请停止并解决它,然后再继续。
如果命令显示现有资源,请先保存副本,然后再进行更改:
kubectl get containernetworkmetric container-network-metric \
  -o yaml > network-metrics-before.yaml
Important
保留仍需的指标条目和筛选器。 若要配置另一个指标,请在 spec.filters下添加一个条目。 如果该指标已有条目,请更新该条目,而不是添加重复项。
例如,如果已筛选 dns 并想要启用 flows-to-world,请保留 dns 该条目,并在其旁边添加一个 flows-to-world 条目。 不要将 DNS 配置替换为新的示例配置。
筛选一个应用程序的流指标
此示例对来自所选应用程序的 Pod 的流观察进行计数。 其他源 Pod 与此筛选器不匹配。 它仅更改 flow 指标。 它不启用可选指标或更改流量权限。
如果资源不存在
运行此 Bash 命令以创建 network-metrics.yaml。 Bash 会用您在上面设置的值替换 ${NAMESPACE} 和 ${POD_PREFIX}:
cat > network-metrics.yaml <<EOF
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: flow
      includeFilters:
        - name: selected-application
          from:
            namespacedPod: ["${NAMESPACE}/${POD_PREFIX}"]
EOF
对于这些示例值,选择器是 production/checkout-:命名空间必须与 production 完全一致,Pod 名称必须以 checkout- 开头。
在 / 后保留 Pod 名称前缀;省略它会选择该命名空间中的每个 Pod。 完整的 Pod 名称还使用前缀匹配,而不是确切的名称比较。
如果资源已存在
不要运行 new-resource 命令。 将备份复制到工作文件:
cp network-metrics-before.yaml network-metrics.yaml
在编辑器中打开工作文件:
- 保留
apiVersion、kind、metadata.name和spec,以及所需的任何用户管理的标签和批注。 删除status和服务器生成的元数据,例如resourceVersion、uidcreationTimestamp、managedFields和kubectl.kubernetes.io/last-applied-configuration批注。 - 保留
spec.filters下的现有条目。 -
如果没有
flow条目,请添加以下示例中所示的条目。 将production/checkout-替换为你的命名空间和应用程序 Pod 名称前缀。 - 如果
flow已存在,请先查看其包含和排除筛选器,然后再编辑它。 若要将其限制为此应用程序,请更新该条目,而不是添加第二flow个条目。 与依赖现有集合的管理员协调对现有集合所做的任何更改。
例如,现有配置可能仅包含 DNS 筛选器:
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: dns
      includeFilters:
        - from:
            namespacedPod: ["production/checkout-"]
添加流筛选器后,完整的配置如下所示:
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: dns
      includeFilters:
        - from:
            namespacedPod: ["production/checkout-"]
    - metric: flow
      includeFilters:
        - name: selected-application
          from:
            namespacedPod: ["production/checkout-"]
这两个示例都是完整的资源。 第二个示例保留第一个示例的 DNS 筛选器并添加流筛选器。 编辑自己的配置时,请保留实际的 DNS 设置和任何其他指标条目。 保持备份不变,以便在清理期间查阅备份。
验证并应用配置
首先,检查群集是否接受 YAML 而不保存更改:
kubectl apply --dry-run=server -f network-metrics.yaml
如果检查失败,请在继续之前更正报告的错误。 如果成功,请应用该文件:
kubectl apply -f network-metrics.yaml
查看资源以检查其状态:
kubectl get containernetworkmetric container-network-metric -o yaml
等待控制器处理更改。 查找 status.state: CONFIGURED 并阅读 status.warnings。 如果状态为 FAILED,请参阅 status.reason,更正文件,并重复验证和应用步骤。 仅配置验收本身并不能说明代理正在生成指标;接下来验证这一点。
生成流量并验证结果
对于托管 Prometheus,请在Azure门户中打开接收Azure Monitor工作区,然后选择指标。 选择 “添加指标>使用编辑器添加”,选择该工作区作为范围,输入 PromQL 查询,然后选择“运行”。 请参阅 PromQL 的指标资源管理器。 不需要Azure 托管 Grafana实例。
如果已使用 Grafana,则可以改为将 Explore 与群集的 Prometheus 数据源配合使用。 对于自己的 Prometheus 服务器,请使用其查询页。 如果后端包含多个群集,请将后端的群集标签选择器添加到查询。
在生成流量之前,请运行此查询。 将源值替换为命名空间和 Pod 名称;PromQL 不替代 Bash 变量。
hubble_flows_processed_total{source="production/<client-pod>"}记录值和时间。 查询可以返回具有不同标签的多个序列。 如果尚不存在序列,请将此情况作为基线记录下来。
在设置工作负荷变量的 Bash 终端中,发出一个请求:
kubectl exec -n "$NAMESPACE" "$CLIENT_POD" -- \
  curl --fail --show-error --silent --output /dev/null \
    --write-out 'HTTP %{http_code}\n' \
    --connect-timeout 10 --max-time 20 "$TEST_URL"
检查已批准的终结点是否成功响应。 在使用结果评估筛选之前,先解决请求失败问题。
等待已配置的 Prometheus 收集间隔和摄取延迟所需的时间,然后再次运行同一查询。 查找测试 Pod 的新系列或现有计数值上升。 计数器不一定每次都恰好增加 1:它计算观察到的流,而不是应用程序请求。
此步骤验证所选 Pod 的收集。 它本身并不能证明所有其他流量都被排除在外。 筛选器更改后,历史序列可以保持可见。 若要测试排除,请在生成已知流量时比较未选定的工作负荷的计数器更改,而不是期望其旧系列消失。
如果未显示任何新值,请使用 指标配置疑难解答。 备用 直接代理检查 可以帮助区分代理收集与后端收集问题。
DNS、TCP、HTTP 和丢弃筛选示例
本节中的每个示例都是完整的 ContainerNetworkMetric 资源。 选择适合你的任务的示例,替换其工作负荷名称或标签,并将其另存为 network-metrics.yaml。
Important
这些示例是可替代的方案,而不是要依次采用的独立选项。 它们都更新相同的群集范围配置。 如果资源已存在,请在应用更改之前将其其他指标条目和筛选器保留在文件中。 请参阅完整的前后对比示例。
对于每个更改,请执行验证并应用配置。 然后,使用生成流量并验证结果中所述的相同前后检查,并使用适合该指标的流量。 在筛选器和查询中使用自己的工作负荷名称。
选择示例仅使用包含筛选器。 单独的 排除示例 演示如何在省略工作负荷的同时保持广泛收集。 有关将包含与例外结合的方法,请参阅 筛选器参考。
按标签选择工作负荷
此配置从标记 app: checkout的 Pod 中选择 TCP 指标观察值。 将标签替换为测试工作负荷使用的应用程序特定的标签。 无需排除任何内容即可选择应用程序。
Important
在当前实现中,与通常的 Kubernetes 标签选择器 AND 行为不同,将独立评估多个标签条件(OR)。
例如,添加 tier: frontend 也会选择具有该标签的 Pod,即使它们未标记 app: checkout。 此示例没有源命名空间限制。 如果需要,请在同一namespacedPod: ["production/"]字段下添加from。
将 production 替换为你的命名空间。 然后,命名空间和标签条件必须匹配。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: tcp
      includeFilters:
        - from:
            labelSelector:
              matchLabels:
                app: checkout
确认源 Pod 具有所选标签:
kubectl get pod -n "$NAMESPACE" "$CLIENT_POD" --show-labels
使用前面的 curl 命令生成 TCP 流量,然后查询 hubble_tcp_flags_total 所选群集和工作负荷。
此指标对符合条件的转发或重定向观察结果的 FIN、SYN、SYN-ACK 和 RST 标志进行计数。 它不计算每个 TCP 数据包或唯一连接。
选择 DNS 请求和答复
使用此示例之前,请通过向工作负荷应用具有 DNS 检查规则的策略来配置 DNS 可见性 。 当工作负荷通过该策略发送 DNS 流量时,将生成 DNS 指标观察值。 仅允许 TCP 或 UDP 端口 53 不会启用检查。
dns指标筛选器不适用或不符合所需策略。
使用两个筛选器在两个方向中包含 DNS 流量。 将 production/client- 替换为客户端的命名空间和 Pod 名称前缀。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: dns
      includeFilters:
        - from:
            namespacedPod: ["production/client-"]
          protocol: ["dns"]
        - to:
            namespacedPod: ["production/client-"]
          protocol: ["dns"]
第一个筛选器选择客户端发送的流量。 第二个筛选发回给它的流量。 任一筛选器都可以匹配。 使用所选 Pod 中安装的 DNS 客户端执行 DNS 查询,然后在指标后端中检查hubble_dns_responses_total和hubble_dns_queries_total。 根据需要在源或目标标签中检查客户端。
更改 DNS 筛选器不会启用 DNS 检查,也不会更改其他度量类型。
为应用程序选择 HTTP 观测结果
使用此示例之前,请完成 使用 ACNS 设置第 7 层 (L7) 策略。
本指南介绍如何在 --acns-advanced-networkpolicies L7 群集上启用 L7 策略并应用 HTTP 策略。 仅 FQDN 筛选就不足以用于此 HTTP 示例。
当您将 HTTP 检查策略应用于工作负载,且 HTTP 流量通过该策略时,您会生成 HTTP 指标观察值。 仅在群集上启用 L7 是不够的。
httpV2筛选器选择这些观察值;它不应用策略或验证工作负荷是否满足这些先决条件。
生成 HTTP 流量并单独检查 hubble_http_requests_total 以验证采集情况,包括 Prometheus 摄取设置。
上述 TCP 示例不需要 HTTP 检查。
使用区分大小写的指标名称 httpV2。 此示例包含来自 production 命名空间中名称以 web- 开头的 pod 或发往这些 pod 的观察值。
将这些名称替换为应用程序的命名空间和 Pod 名称前缀。
处理程序 httpV2 计算 HTTP 响应观察值。 其筛选器使用观察到的响应的源和目标。 然后,将导出的源和目标上下文标签对调,以表示请求方向。 不要假定筛选器的 from 终结点是指标的导出 source 标签。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: httpV2
      includeFilters:
        - name: http-from-web
          from:
            namespacedPod: ["production/web-"]
        - name: http-to-web
          to:
            namespacedPod: ["production/web-"]
生成通过应用程序配置的检查路径接收响应的 HTTP 请求。 在请求前后进行比较 hubble_http_requests_total ,选择正在调查的群集和工作负荷。
添加 httpV2 筛选器不会启用 HTTP 检查或解密 HTTPS 流量。
可选指标示例中的 HTTPS 请求演示的是 TCP world 和端口指标,而不是 HTTP 指标收集。
从丢弃指标中排除工作负荷
此配置会排除位于 production 命名空间中、名称以 load-test- 开头的 Pod 的丢弃观测数据。 将此选择器替换为要排除的测试工作负荷。 其他工作负载仍有资格进行丢弃指标收集。
如果想要保留广泛的丢弃监控,但省略负载测试观测数据,而不是选择一个应用程序,请使用这种仅排除方法。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: drop
      excludeFilters:
        - from:
            namespacedPod: ["production/load-test-"]
此配置既不会防止也不会导致数据包丢失。 它会更改哪些现有丢弃事件会对 hubble_drop_total 产生贡献。 应在经批准的测试环境中,使用已知会被丢弃的测试流量进行验证,而不是通过中断生产工作负载来验证。
按安全身份筛选流量指标
Cilium 安全身份是分配给端点或端点类别的数字标识符。 它既不是 Azure 的托管标识,也不是用户标识。 您可以在源筛选器或目标筛选器中使用该项,而无需选择单个 IP 地址。 检查集群是否支持标识筛选器:
kubectl explain containernetworkmetric.spec.filters.includeFilters.to.identities
以下示例将流量指标限制为从结账应用程序发往 world(外部)身份的 TCP 流量。 将其保存为 network-metrics.yaml,并将 production/checkout- 替换为你的命名空间和应用程序 Pod 名称前缀。 如果资源已存在,则保留其其他指标条目,并更新其现有的 flow 条目。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: flow
      includeFilters:
        - name: checkout-world-traffic
          from:
            namespacedPod: ["production/checkout-"]
          to:
            identities: [2, 9, 10]
          protocol: ["tcp"]
标识 2 表示全球,9 表示全球 IPv4,10 表示全球 IPv6。 列出 2 并不会自动包含另外两个。 某些外部目标具有不同的标识,并且与此筛选器不匹配。 API 接受从 到 的数值,而不接受诸如 之类的别名。
验证、应用,并重复执行第一个示例中的流量和查询步骤。 使用经批准且分类为“世界”的外部目标位置。 此筛选器更改计数的流;它不会将目标 IP 标签添加到流指标。 若要查看外部目标 IP 地址,请使用下一部分中的可选指标。
启用附加指标
当该服务尚未提供该指标时,请使用 spec.filters 下的筛选条目来启用 flows-to-world 或 port-distribution 此资源中没有单独的启用标志。 下面的每个示例都是针对一个指标的完整配置。 在应用它之前,先保留现有的指标条目。
如果该服务已启用某个指标,CNM 会对该指标进行筛选,而不替换其现有标签或选项。 以下说明显示了 CNM 添加指标时使用的服务拥有的选项。 在将集群上的结果与现有配置进行比较时,请检查输出的标签。
| Action | CNM 条目添加的指标 | 服务已提供该指标 |
|---|---|---|
| 添加筛选项 | 启用并筛选指标。 | 筛选指标;保留其服务提供的标签和选项。 |
| 删除该条目 | 禁用指标。 | 在不使用该条目筛选器的情况下,保持该指标处于启用状态。 |
| 删除 CNM | 删除 CNM 添加的指标。 | 还原服务提供的集合,而不使用任何 CNM 筛选器。 |
若要启用这两个指标,请在同一资源中,在 spec.filters 下包含这两个条目。
用于捕获结果的配置同时显示这两个指标,并保留现有的 DNS 条目。
检查到外部目标的 TCP 流量
使用此配置从签出 Pod production 到具有世界标识的目标选择 TCP 流量。 将 production/checkout- 替换为你的命名空间和应用程序 Pod 名称前缀。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: flows-to-world
      includeFilters:
        - name: checkout-world-egress
          from:
            namespacedPod: ["production/checkout-"]
          to:
            identities: [2, 9, 10]
          protocol: ["tcp"]
          verdict: ["forwarded"]
对于通过 CNM 新启用的指标,该服务使用仅限 SYN 的计数:发往全球目标地址的符合条件的非回复 TCP SYN 观测数据。 它不统计 UDP 流量。 此示例进一步限制对转发流量的观察。 重复的 SYN 观察对于一次连接尝试,可能使计数器增加多次,因此计数器不是成功连接的计数。
按照验证并应用配置,然后使用此指标重复前面的基线、curl和查询步骤。
使用相同的 $NAMESPACE、$CLIENT_POD 和 $TEST_URL 值,目标分类为世界。
在 Prometheus 中查询 hubble_flows_to_world_total。 对于包含多个群集的工作区,请在比较结果之前选择正在调查的群集。
将下面的源值替换为命名空间和 Pod 名称:
hubble_flows_to_world_total{source="production/<client-pod>"}
从测试中查找所选的源 Pod、目标 IP 和新观察结果。 源标签和目标标签来自由服务管理的上下文,而不是通过添加身份筛选器获得的。 分配了不同标识的目标与示例不匹配。
检查目标端口
使用此完整配置查看 checkout Pod 使用的 TCP 和 UDP 目标端口。 将 production/checkout- 替换为你的命名空间和应用程序 Pod 名称前缀。 如果已启用 flows-to-world 并想要保留它,请在应用此文件之前保留文件中的 flows-to-world 条目。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: port-distribution
      includeFilters:
        - name: checkout-ports
          from:
            namespacedPod: ["production/checkout-"]
          protocol: ["tcp", "udp"]
按照前面的步骤验证并应用该文件。 记录基线数据,使用前面的 curl 命令生成 TCP 流量,并检查目标端口。
将源值替换为命名空间和 Pod 名称:
hubble_port_distribution_total{source="production/<client-pod>"}
protocol 和 port 标签标识协议和目标端口。
指标对代理标识为不是答复的转发或重定向流量进行计数。 丢失的流量和具有未知回复状态的流量不会计入。
verdict: ["dropped"]筛选器不会更改此行为。
HTTPS 请求通常会生成 TCP/443 观测结果。 如果 Pod 通过 UDP 执行 DNS 查找,则还可以显示 UDP/53 观察值;缓存解析可能不会生成新的 DNS 流量。
直接在代理程序处检查指标
如果后端查询没有数据,或者您希望终端输出如以下屏幕截图所示,请使用此检查。 它直接从测试 Pod 节点上的 Cilium 代理读取指标。 它不验证 Prometheus 是否已收集它们。
需要有权限在 kube-system 中列出 Pod 并进行端口转发,以及具有本地 curl。
在包含测试工作负荷变量的终端中,找到其节点并列出该节点上的 Cilium Pod:
NODE=$(kubectl get pod -n "$NAMESPACE" "$CLIENT_POD" \
  -o jsonpath='{.spec.nodeName}')
kubectl get pods -n kube-system -l k8s-app=cilium \
  --field-selector "spec.nodeName=$NODE" -o wide
如果命令失败或未列出 Cilium Pod,请停止。 设置命令返回的名称,然后启动端口转发:
CILIUM_POD="<cilium-pod-on-the-test-node>"
kubectl -n kube-system port-forward --address 127.0.0.1 \
  "pod/$CILIUM_POD" 19965:9965
使此终端保持运行状态。 在第二个 Bash 终端中,设置测试 Pod 的确切源标签并提取指标:
SOURCE="<namespace>/<client-pod>"
date -u '+Scrape time (UTC): %Y-%m-%dT%H:%M:%SZ'
curl --fail --silent --show-error --max-time 15 \
  http://127.0.0.1:19965/metrics > agent-metrics.prom &&
grep -E '^hubble_(flows_processed|flows_to_world|port_distribution)_total[{]' \
  agent-metrics.prom | grep -F "source=\"$SOURCE\""
如果 curl 报告错误,请检查端口转发以及代理是否在端口 9965 上公开指标。 如果成功但未显示匹配行,请检查源值、所选代理、指标配置和测试流量。 不要将空结果解释为筛选正常工作的证据。
在新流量前后重复抓取,以比较计数器。 保留 UTC 时间和完整标签,以便比较同一序列。 完成端口转发后,在第一个终端中按 Ctrl+C 。
示例配置和捕获的结果
以下示例演示用于从 cnm-capture-client Cilium 群集的命名空间中的 cnm-docs Pod 收集这两个指标的配置。
该测试生成了 DNS 查找和 8 个发送到 https://www.microsoft.com 的 HTTPS 请求。 所有 8 个 HTTPS 请求都返回了 HTTP 200。
用于测试的自定义资源
这是完整的已应用配置,其中省略了服务器生成的元数据和状态。 保留了现有dns条目;测试向同一资源添加了flows-to-world和port-distribution。
apiVersion: acn.azure.com/v1alpha1
kind: ContainerNetworkMetric
metadata:
  name: container-network-metric
spec:
  filters:
    - metric: dns
      includeFilters:
        - name: dns-from-demo-client
          from:
            namespacedPod: ["pets/acns-panel-client-"]
        - name: dns-to-demo-client
          to:
            namespacedPod: ["pets/acns-panel-client-"]
    - metric: flows-to-world
      includeFilters:
        - name: cnm-docs-world-egress
          from:
            namespacedPod: ["cnm-docs/cnm-capture-client"]
          to:
            identities: [2, 9, 10]
          protocol: ["tcp"]
          verdict: ["forwarded"]
    - metric: port-distribution
      includeFilters:
        - name: cnm-docs-destination-ports
          from:
            namespacedPod: ["cnm-docs/cnm-capture-client"]
          protocol: ["tcp", "udp"]
world 筛选器选择从测试客户端转发到具有 world 标识的目标的 TCP 观测记录。 端口筛选器从同一客户端中选择 TCP 和 UDP 观测结果。 在 namespacedPod 中的 Pod 名称作为前缀进行匹配;测试使用了具有此名称的单个 Pod。
该 dns 条目从以前的配置中选择不同的工作负荷。 不需要启用任一可选指标,包括在 port-distribution 中的 UDP/53 观察值。
Important
此示例使用测试群集的 Pod 和命名空间名称。 在使用它们之前,请将其替换为自己的名称。 如果群集已有此资源,请仅添加或更新所需的指标条目,并保留其他设置。
控制器处理更改后,资源报告 status.state: CONFIGURED。 它还警告说,每个可选指标可能会增加时序的数量和存储它们的成本。 在生成流量之前,代理使用的配置中也验证了这两个指标。 若要检查资源的状态和警告,请运行:
kubectl get containernetworkmetric container-network-metric -o yaml
全局指标结果
以下屏幕截图显示了 2026 年 11 月 2 日 16:41:33 UTC 的代理直接抓取。 对于源 cnm-docs/cnm-capture-client,该 hubble_flows_to_world_total 示例显示文档地址 203.0.113.10、协议 TCP、判决 FORWARDED和值 8。

cnm-docs-world-egress 筛选器选择的客户端的“全局”指标输出。
屏幕截图和示例说明中的目标 IP 已替换为 203.0.113.10为文档保留的地址。 对于你自己的测试,请使用已批准的可访问目标,而不是此示例地址。
目标端口结果
以下屏幕截图显示了使用相同源 Pod 和配置在 2026 年 11 月 2 日 16:43:28 UTC 的直接代理报废。
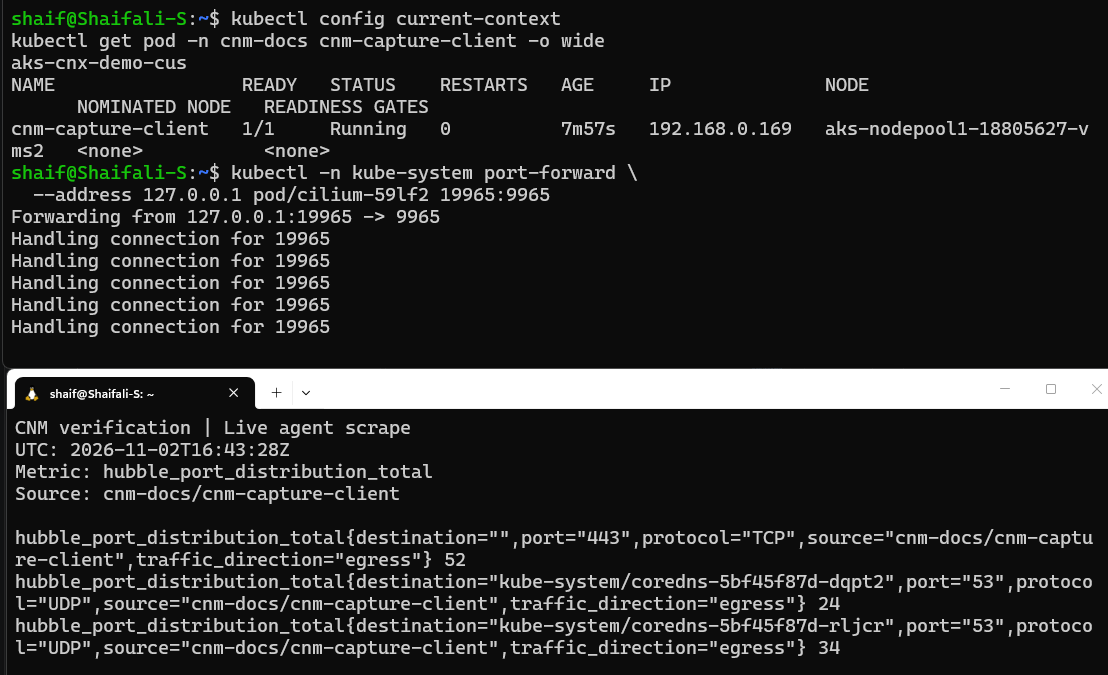
cnm-docs-destination-ports 筛选器选择的客户端的目标端口输出。
| Protocol | 目标端口 | 目标标签 | 计数器值 |
|---|---|---|---|
| TCP | 443 | 空:无目标 Pod 元数据 | 52 |
| UDP | 53 | kube-system/coredns-5bf45f87d-dqpt2 |
24 |
| UDP | 53 | kube-system/coredns-5bf45f87d-rljcr |
34 |
这三个系列都有 traffic_direction="egress"。 TCP/443 系列上的空目标标签,对于没有 Pod 元数据的外部目标,这是符合预期的。
这些累积计数器计算观察值,而不是唯一的请求或连接。 在捕获屏幕截图之前,测试流量从 15:09:13 运行到 15:09:48 UTC。 屏幕截图中的时间戳标识抓取记录,而不是流量时间间隔。 值和目标地址在另一次运行中可能有所不同。
这些屏幕截图显示代理生成了指标。 它们不显示 Azure Monitor 是否收到这些指标,或 Grafana 是否显示了这些指标。 如前面的过程中所述,单独检查 Prometheus 后端。
过滤器参考
| 领域 | Description |
|---|---|
spec.filters |
要筛选的指标列表。 至少包括一个条目。 仅使用每个指标名称一次。 |
metric |
本指南中介绍的指标类型:flow、dns、drop、httpV2、tcp、flows-to-world和port-distribution。 |
includeFilters |
要包含此指标的流量。 |
excludeFilters |
要排除此指标的流量。 |
name |
指标筛选器的可选名称。 仅名称不选择流量。 |
from, to |
选择流量来源或去向,使用 namespacedPod、ip、labelSelector 或 identities。 |
labelSelector |
在当前实现中,单独的 matchLabels 条目和 matchExpressions 是替代关系(OR),而不是组合要求(AND)。 请参阅 按标签选择工作负荷。 |
identities |
数值 Cilium 标识从 0 到 16777215。 列表中的值是替代项。 |
protocol |
tcp, udp 或 dns。 |
verdict |
forwarded 或 dropped。 |
每个指标条目至少需要一个包含或排除筛选器。 每个筛选器都必须指定流量选择条件,例如 Pod 名称或协议。
- 在一个筛选器中,不同的填充条件必须匹配(AND):源和目标选择器、协议和判决。 同一终结点上的不同选择器字段(例如
namespacedPod,以及labelSelector)也必须匹配在一起。 例如,protocol: ["tcp"]下的namespacedPod: ["production/checkout-"]与from一起,仅选择来自production中 checkout Pod 的 TCP 流量。 - 在
namespacedPod、ip、identities、protocol或verdict列表中的值是替代项(OR)。 例如,protocol: ["tcp", "udp"]匹配任一协议。 - 在每个端点的
labelSelector中,每个matchLabels条目和每个matchExpressions项都会成为一个单独的选择器。 任何一个都可以匹配 (OR) 。 添加另一个标签条件不需要同时满足两个标签条件。 - 使用多个包含筛选器,流量可以匹配其中任一筛选器。
- 如果流量与排除筛选器匹配,则即使流量也与包含筛选器匹配,也不会对其进行计数。
例如,包含筛选器 production/checkout-,以及用于 production/checkout-load-test- 的排除筛选器,会选择 checkout Pod,但名称以 checkout-load-test- 开头的 Pod 除外。 如果仅提供排除筛选器,则指标将继续对它通常计数的其他流量进行计数。
对于全球流量,标识 2 表示全球,9 表示全球 IPv4,10 表示全球 IPv6。 列出 2 并不会展开为全部三个。 使用与观察到的流量匹配的数字标识;并非每个外部终结点都必须具有世界标识。
对于 DNS 和 HTTP 指标,请单独配置协议检查。 仅指标筛选器不显示 DNS 或 HTTP 详细信息。
指标配置疑难解答
| 问题 | Action |
|---|---|
该命令将返回 Forbidden,或报告连接错误。 |
检查权限、当前的 Kubernetes 上下文和群集连接。 这些错误并不意味着资源缺失。 请先解决该错误,再更改配置。 |
| API 拒绝该 YAML 文件。 | 使用资源名称 container-network-metric。 检查指标名称和标识范围,并至少包含一个用于选择流量的筛选器。 |
该资源报告 FAILED。 |
阅读 status.reason。 检查重复的指标条目,或没有流量条件的筛选器。 |
| 出现一条提及基数或引入成本的警告。 | 其他指标可以创建更多时序并增加存储成本。 从一小部分工作负荷开始,并检查收集的数据量。 |
| 警告显示指标不在基本配置中。 | 检查群集的托管指标配置。 此警告并非用于检查工作负载是否具有所需的检查策略或是否正在生成流量。 |
该资源为 CONFIGURED,但没有出现新的观测。 |
筛选器状态不能确认是否生成了观察结果。 对于 DNS,应用 DNS 检查策略并生成 DNS 查询。 对于 HTTP,启用 L7,应用 HTTP 检查策略,并通过该策略生成 HTTP 流量。 然后检查流量选择、特定于指标的计数行为,以及 Prometheus 抓取管道。 |
| 代理显示示例,但后端不显示。 | 检查抓取配置、摄取延迟、群集选择和后端标签名称。 代理抓取不会验证后端摄取。 |
| 来自被排除工作负载的旧序列仍然可见。 | 比较受控流量期间的新计数器更改。 筛选不会删除历史样本,也不能保证立即删除现有时间序列。 |
| 标签筛选包含的工作负载比预期更多。 | 多个标签条目独立匹配(OR)。 检查与任何条目匹配的 Pod,包括在其他命名空间中。 使用一个特定于应用程序的标签条件,并在需要时将其与命名空间/Pod 选择器组合在一起。 |
| 删除可选指标后,该指标将保留。 | 检查服务是否提供它。 删除 CNM 筛选器不会禁用服务提供的指标。 |
| 全局或端口计数器没有增加。 | 验证目标标识和处理程序资格。 全局仅 SYN 计数不包括 UDP;端口分布不包括被丢弃的观测或回复观测。 |
该服务管理指标标签。 此资源配置筛选器,而不是自定义标签集。
还原以前的配置
如果在开始之前存在资源,请使用保存的副本来标识已更改的设置。 仅撤消您自己的测试更改。 保存副本后,保留其他管理员所做的任何更改。
- 仅当该项曾启用它时,删除
flows-to-world或port-distribution项才会将其禁用。 服务已提供的指标保持启用状态。 - 删除默认指标的筛选器条目会还原其默认集合行为。 它不会禁用默认指标。
在工作清单中还原您的编辑,对其进行验证,并使用 验证并应用配置。 重新检查状态和新的观察结果。 解除限制可能会增加收集,因此请与资源的其他用户协调还原。
如果为此示例创建了资源,现在没有人依赖于它,请将其删除以还原服务的默认指标配置:
kubectl delete containernetworkmetric container-network-metric
以前收集的时间序列仍受后端保留策略的约束。
最佳做法
- 在广泛应用这些筛选器之前,先在小工作负载上测试它们。
- 查看包括列表和排除列表;排除项优先。
- 对工作负荷使用标签或 Pod 选择器,对基于标识的选择使用数字标识。
- 启用可选指标时查看摄取量。
- 与其他群集管理员协调更改。 资源跨群集共享,不限于一个命名空间。
局限性
- 指标筛选需要 Cilium 数据平面以及本文前面所述的先决条件。
- 每个群集仅支持一个
ContainerNetworkMetric资源。 - 一个端点的
labelSelector中的多个条件被评估为替代项,而不是 Kubernetes 风格的 AND 要求。 此评估方法适用于包括和排除筛选器。 - 筛选器影响新观察;历史数据可以保持可见。
- 该服务将继续管理指标维度。
- 筛选器无法让指标统计其处理程序已排除的流量。
相关内容
- 若要了解容器网络指标功能,请参阅 容器网络指标概述。
- 若要使用高级容器网络服务创建 AKS 群集,请参阅 设置 AKS 的容器网络可观测性。
- 有关详细信息,请参阅 AKS 的高级容器网络服务。