适用于: Azure 数据工厂 Azure Synapse Analytics
本文概述了如何使用 Azure 数据工厂 和 Azure Synapse 管道中的复制活动从 Snowflake 复制数据,以及如何使用数据流在 Snowflake 中转换数据。 有关详细信息,请参阅 Data Factory 或 Azure Synapse Analytics 的介绍性文章。
重要
Snowflake V1 连接器处于 删除阶段。 建议将 Snowflake 连接器 从 V1 升级到 V2。
支持的功能
此 Snowflake 连接器支持以下功能:
| 支持的功能 | IR |
|---|---|
| 复制活动 (源/接收器) | (1) (2) |
| 映射数据流(源/汇) | (1) |
| 查询活动 | (1) (2) |
| 脚本活动 | (1) (2) |
(1) Azure集成运行时 (2) 自承载集成运行时
对于复制活动,此 Snowflake 连接器支持以下功能:
- 从 Snowflake 复制数据:利用 Snowflake 的 COPY into [location] 命令实现最佳性能。
- 将数据复制到 Snowflake 中:利用 Snowflake 的 COPY into [table] 命令实现最佳性能。 它支持Azure上的 Snowflake。
- 如果需要通过代理从自托管的Integration Runtime连接到 Snowflake,则必须在Integration Runtime主机上为HTTP_PROXY和HTTPS_PROXY配置环境变量。
先决条件
如果数据存储位于本地网络、Azure虚拟网络或 Amazon 虚拟私有云中,则需要配置自承载集成运行时以连接到它。 确保将自承载集成运行时使用的 IP 地址添加到允许列表中。
如果数据存储是托管的云数据服务,则可以使用Azure Integration Runtime。 如果访问仅限于防火墙规则中批准的 IP,则可以将 Azure Integration Runtime IP添加到允许的列表。
用于源或接收器的 Snowflake 帐户应具有对数据库的必要 USAGE 访问权限以及对架构及其下的表/视图的读/写访问权限。 此外,它还应该在架构上具有 CREATE STAGE,以便能够使用 SAS URI 创建外部阶段。
必须设置以下帐户属性值
| 属性 | 描述 | 必需的 | 默认 |
|---|---|---|---|
| 需要存储集成以创建阶段 | 指定在创建命名的外部阶段(使用 CREATE STAGE)访问私有云存储位置时是否需要存储集成对象作为云凭证。 | 假 | 假 |
| 需要为阶段操作集成存储 | 指定在从私有云存储位置加载数据或将数据卸载到私有云存储位置时,是否需要使用引用存储集成对象作为云凭证的命名外部阶段。 | 假 | 假 |
要详细了解网络安全机制和数据工厂支持的选项,请参阅数据访问策略。
开始
若要使用管道执行复制活动,可以使用以下工具或 SDK 之一:
使用 UI 创建到 Snowflake 的链接服务
使用以下步骤在 Azure 门户 UI 中创建到 Snowflake 的链接服务。
浏览到 Azure 数据工厂或 Synapse 工作区中的“管理”选项卡,并选择“链接服务”,然后单击“新建”:
搜索“Snowflake”并选择“Snowflake 连接器”。

配置服务详细信息、测试连接并创建新的链接服务。

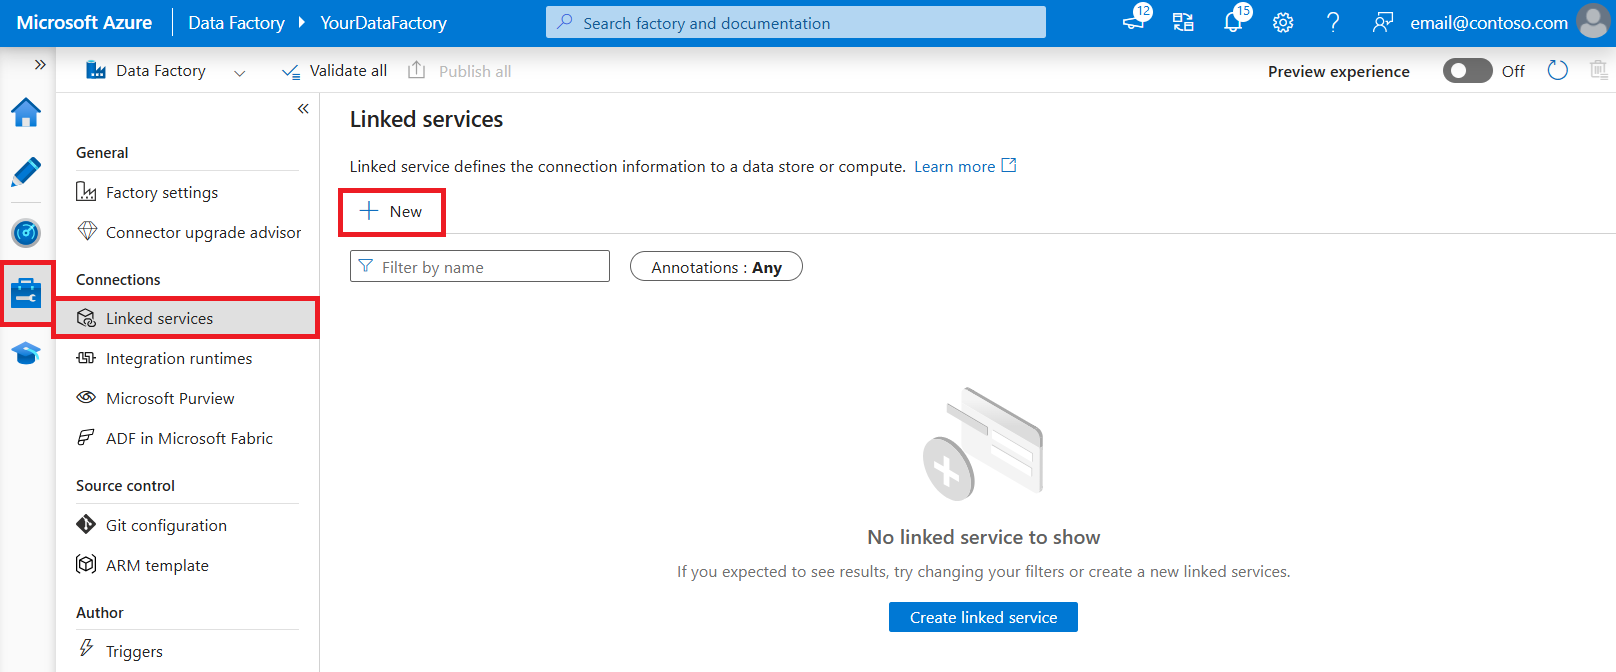
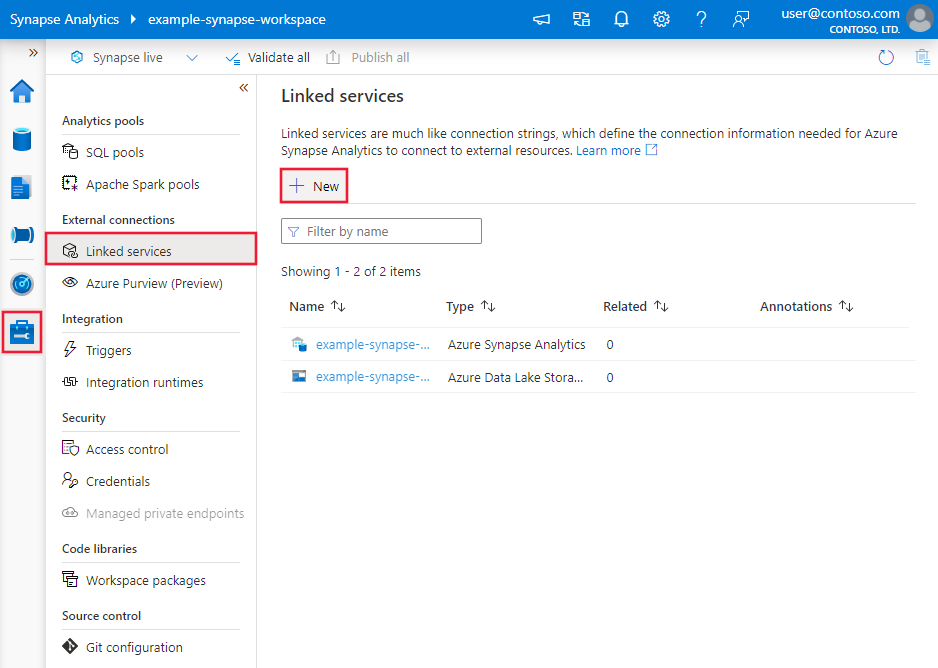
连接器配置详细信息
以下部分详细介绍了用来定义特定于 Snowflake 连接器的实体的属性。
连接的服务属性
此 Snowflake 连接器支持以下身份验证类型。 有关详细信息,请参阅相应部分。
基本身份验证
使用基本身份验证时,Snowflake 链接服务支持以下属性。
| 属性 | 描述 | 必需的 |
|---|---|---|
| 类型 | type 属性必须设置为 Snowflake。 | 是 |
| connectionString | 指定连接到 Snowflake 实例所需的信息。 可以选择将密码或整个连接字符串放入Azure 密钥保管库。 有关更多详细信息,请参阅下表下方的示例以及文章《在 Azure 密钥保管库 中存储凭据》。 部分典型设置: - 帐户名称: Snowflake 帐户 的完整帐户名称 (包括标识区域和云平台的其他段),例如 xy12345.east-cn-2.azure。 - 用户名:用于连接的用户登录名。 - 密码:用户的密码。 - 数据库:要在连接后使用的默认数据库。 它应为指定角色具有权限的现有数据库。 - 仓库:连接后要使用的虚拟仓库。 它应为指定角色具有权限的现有仓库。 - 角色:在 Snowflake 会话中默认使用的访问控制角色。 指定角色应为已分配给指定用户的现有角色。 默认角色为 PUBLIC。 |
是 |
| authenticationType | 将此属性设置为“基本”。 | 是 |
| 连接方式 | 用于连接到数据存储的集成运行时。 可以使用Azure集成运行时或自承载集成运行时(如果数据存储位于专用网络中)。 如果未指定,则使用默认Azure集成运行时。 | 否 |
示例:
{
    "name": "SnowflakeLinkedService",
    "properties": {
        "type": "Snowflake",
        "typeProperties": {
            "authenticationType": "Basic",
            "connectionString": "jdbc:snowflake://<accountname>.snowflakecomputing.com/?user=<username>&password=<password>&db=<database>&warehouse=<warehouse>&role=<myRole>"
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
Azure 密钥保管库 中的密码:
{
    "name": "SnowflakeLinkedService",
    "properties": {
        "type": "Snowflake",
        "typeProperties": {
            "authenticationType": "Basic",
            "connectionString": "jdbc:snowflake://<accountname>.snowflakecomputing.com/?user=<username>&db=<database>&warehouse=<warehouse>&role=<myRole>",
            "password": {
                "type": "AzureKeyVaultSecret",
                "store": {
                    "referenceName": "<Azure Key Vault linked service name>",
                    "type": "LinkedServiceReference"
                },
                "secretName": "<secretName>"
            }
        },
        "connectVia": {
            "referenceName": "<name of Integration Runtime>",
            "type": "IntegrationRuntimeReference"
        }
    }
}
数据集属性
有关可用于定义数据集的各部分和属性的完整列表,请参阅数据集一文。
Snowflake 数据集支持以下属性。
| 属性 | 描述 | 必需的 |
|---|---|---|
| 类型 | 数据集的 type 属性必须设置为 SnowflakeTable。 | 是 |
| 架构 | 架构的名称。 请注意,架构名称区分大小写。 | 对于源为“否”,对于接收器为“是” |
| 表 | 表/视图的名称。 请注意,表名称区分大小写。 | 对于源为“否”,对于接收器为“是” |
示例:
{
    "name": "SnowflakeDataset",
    "properties": {
        "type": "SnowflakeTable",
        "typeProperties": {
            "schema": "<Schema name for your Snowflake database>",
            "table": "<Table name for your Snowflake database>"
        },
        "schema": [ < physical schema, optional, retrievable during authoring > ],
        "linkedServiceName": {
            "referenceName": "<name of linked service>",
            "type": "LinkedServiceReference"
        }
    }
}
复制活动 属性
有关可用于定义活动的各部分和属性的完整列表,请参阅管道一文。 本部分提供 Snowflake 源和接收器支持的属性列表。
将 Snowflake 作为数据源
Snowflake 连接器利用 Snowflake 的 COPY into [location] 命令实现最佳性能。
如果 Snowflake COPY 命令原生支持接收器数据存储和格式,则可以使用 "复制活动" 直接从 Snowflake 复制到接收器。 有关详细信息,请参阅直接从 Snowflake 复制。 否则,请使用内置的Snowflake 暂存复制功能。
若要从 Snowflake 复制数据,复制活动 source 节支持以下属性。
| 属性 | 描述 | 必需的 |
|---|---|---|
| 类型 | 复制活动 源的 type 属性必须设置为 SnowflakeSource。 | 是 |
| 查询 | 指定要从 Snowflake 读取数据的 SQL 查询。 如果架构、表和列的名称包含小写,则引用查询中的对象标识符,例如 select * from "schema"."myTable"。不支持执行存储过程。 |
否 |
| 导出设置 | 用于从 Snowflake 检索数据的高级设置。 可以配置由 COPY INTO 命令支持的设置。当调用语句时,该服务会传递这些设置。 | 是 |
在 exportSettings 下: |
||
| 类型 | 导出命令的类型,设置为 SnowflakeExportCopyCommand。 | 是 |
| 附加复制选项 | 其他复制选项,作为键值对的字典提供。 示例:MAX_FILE_SIZE、OVERWRITE。 有关详细信息,请参阅 Snowflake 复制选项。 | 否 |
| 附加格式选项 | 提供给 COPY 命令的附加文件格式选项,以键值对形式的字典表示。 示例:DATE_FORMAT、TIME_FORMAT、TIMESTAMP_FORMAT。 有关详细信息,请参阅 Snowflake 格式类型选项。 | 否 |
注意
请确保您有执行以下命令的权限,并可访问架构 INFORMATION_SCHEMA 和表 COLUMNS。
COPY INTO <location>
直接复制自 Snowflake
如果接收器数据存储和格式符合本节中所述的条件,则可以使用复制活动直接从 Snowflake 复制到接收器。 如果未满足以下条件,服务将会检查设置,并让Copy活动运行失败。
接收器链接服务是使用Azure Blob 存储和共享访问签名身份验证。 如果想要以以下受支持的格式直接将数据复制到Azure Data Lake Storage Gen2,则可以针对 ADLS Gen2 帐户创建具有 SAS 身份验证的 Azure Blob 链接服务,以避免使用来自 Snowflake 的 标记副本。
接收器数据格式为“Parquet”、“带分隔符的文本”或“JSON”,其配置如下 :
- 对于“Parquet”格式,压缩编解码器为“None”、“Snappy”或“Lzo”。
- 对于“带分隔符的文本”格式:
-
rowDelimiter为 \r\n 或任何单个字符。 -
compression可为“无压缩”、 gzip、bzip2 或 deflate。 -
encodingName保留为默认值或设置为 utf-8。 -
quoteChar为双引号、单引号或空字符串(无引号字符) 。
-
- 对于“JSON”格式,直接复制只支持以下情况:源 Snowflake 表或查询结果仅有一列且该列的数据类型是“VARIANT”、“OBJECT”或“ARRAY” 。
-
compression可为“无压缩”、 gzip、bzip2 或 deflate。 -
encodingName保留为默认值或设置为 utf-8。 -
filePattern在复制活动馈入中保留为默认值或设置为“setOfObjects”。
-
在复制活动源中,
additionalColumns未指定。列映射未指定。
示例:
"activities":[
    {
        "name": "CopyFromSnowflake",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Snowflake input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SnowflakeSource",
                "query": "SELECT * FROM MYTABLE",
                "exportSettings": {
                    "type": "SnowflakeExportCopyCommand",
                    "additionalCopyOptions": {
                        "MAX_FILE_SIZE": "64000000",
                        "OVERWRITE": true
                    },
                    "additionalFormatOptions": {
                        "DATE_FORMAT": "'MM/DD/YYYY'"
                    }
                }
            },
            "sink": {
                "type": "<sink type>"
            }
        }
    }
]
从 Snowflake 进行暂存复制
如果接收器的数据存储或格式与 Snowflake COPY 命令本机不兼容,如上一部分所述,请使用 Azure Blob 临时存储实例启用内置分阶段复制。 分阶段复制功能还能够提供更高的吞吐量。 该服务将数据从 Snowflake 导出到临时存储,然后将数据复制到目标存储,最后从临时存储中清理您的临时数据。 若要详细了解如何通过暂存方式复制数据,请参阅暂存复制。
若要使用此功能,请创建Azure Blob 存储链接服务,该服务将Azure存储帐户称为临时暂存。 然后,在复制活动中指定 enableStaging 和 stagingSettings 属性。
注意
阶段性 Azure Blob 存储链接服务必须使用 Snowflake COPY 命令所需的共享访问签名认证。 请确保在暂存Azure Blob 存储中向 Snowflake 授予适当的访问权限。 要了解详细信息,请参阅本文。
示例:
"activities":[
    {
        "name": "CopyFromSnowflake",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<Snowflake input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "SnowflakeSource",
                "query": "SELECT * FROM MyTable",
                "exportSettings": {
                    "type": "SnowflakeExportCopyCommand"
                }
            },
            "sink": {
                "type": "<sink type>"
            },
            "enableStaging": true,
            "stagingSettings": {
                "linkedServiceName": {
                    "referenceName": "MyStagingBlob",
                    "type": "LinkedServiceReference"
                },
                "path": "mystagingpath"
            }
        }
    }
]
以 Snowflake 作为接收器
Snowflake 连接器利用 Snowflake 的 COPY into [table] 命令以实现最佳性能。 它支持在 Azure 上将数据写入 Snowflake。
如果 Snowflake COPY 命令原生支持源数据存储和格式,则可以直接使用复制活动从源复制到 Snowflake。 有关详细信息,请参阅直接复制到 Snowflake。 否则,请使用内置的暂存复制到 Snowflake。
若要将数据复制到 Snowflake,复制活动 sink 节支持以下属性。
| 属性 | 描述 | 必需的 |
|---|---|---|
| 类型 | 复制活动接收器的 type 属性,设置为 SnowflakeSink。 | 是 |
| preCopyScript | 在每次运行中将数据写入 Snowflake 之前,请为要运行的复制活动指定 SQL 查询。 使用此属性清理预加载的数据。 | 否 |
| 导入设置 | 用于将数据写入 Snowflake 的高级设置。 可以配置由 COPY INTO 命令支持的设置。当调用语句时,该服务会传递这些设置。 | 是 |
在 importSettings 下: |
||
| 类型 | 导入命令的类型,设置为 SnowflakeImportCopyCommand。 | 是 |
| 附加复制选项 | 其他复制选项,作为键值对的字典提供。 示例:ON_ERROR、FORCE、LOAD_UNCERTAIN_FILES。 有关详细信息,请参阅 Snowflake 复制选项。 | 否 |
| 附加格式选项 | 提供给 COPY 命令的其他文件格式选项以键值对字典形式存在。 示例:DATE_FORMAT、TIME_FORMAT、TIMESTAMP_FORMAT。 有关详细信息,请参阅 Snowflake 格式类型选项。 | 否 |
注意
请确保您有执行以下命令的权限,并可访问架构 INFORMATION_SCHEMA 和表 COLUMNS。
SELECT CURRENT_REGION()COPY INTO <table>SHOW REGIONSCREATE OR REPLACE STAGEDROP STAGE
直接复制到 Snowflake
如果源数据存储和格式符合本节中所述的条件,则可以使用复制活动直接从源复制到 Snowflake。 如果未满足以下条件,服务将会检查设置,并让Copy活动运行失败。
源链接服务Azure Blob 存储使用共享访问签名进行身份验证。 如果要以以下受支持的格式直接从 Azure Data Lake Storage Gen2 复制数据,可以为 ADLS Gen2 帐户创建使用 SAS 身份验证的 Azure Blob 链接服务,从而避免使用 阶段性复制到 Snowflake。
“源数据格式”为“Parquet”、“带分隔符的文本”或“JSON”,其配置如下 :
对于“Parquet”格式,压缩编解码器为“无压缩”或“Snappy”。
对于“带分隔符的文本”格式:
-
rowDelimiter为 \r\n 或任何单个字符。 如果行分隔符不是“\r\n”,则firstRowAsHeader需要为 false,并且 未指定。skipLineCount -
compression可为“无压缩”、 gzip、bzip2 或 deflate。 -
encodingName保留为默认值或设置为“UTF-8”、“UTF-16”、“UTF-16BE”、“UTF-32”、“UTF-32BE”、“BIG5”、“EUC-JP”、“EUC-KR”、“GB18030”、“ISO-2022-JP”、“ISO-2022-KR”、“ISO-8859-1”、“ISO-8859-2”、“ISO-8859-5”、“ISO-8859-6”、“ISO-8859-7”、“ISO-8859-8”、“ISO-8859-9”、“WINDOWS-1250”、“WINDOWS-1251”、“WINDOWS-1252”、“WINDOWS-1253”、“WINDOWS-1254”、“WINDOWS-1255”。 -
quoteChar为双引号、单引号或空字符串(无引号字符) 。
-
对于“JSON”格式,直接复制只支持以下情况:接收器 Snowflake 表仅有一列且该列的数据类型是“VARIANT”、“OBJECT”或“ARRAY” 。
-
compression可为“无压缩”、 gzip、bzip2 或 deflate。 -
encodingName保留为默认值或设置为 utf-8。 - 列映射未指定。
-
在复制活动的源数据中:
- 未指定
additionalColumns。 - 如果源为文件夹,则将
recursive设置为 true。 -
prefix、modifiedDateTimeStart、modifiedDateTimeEnd和enablePartitionDiscovery未指定。
- 未指定
示例:
"activities":[
    {
        "name": "CopyToSnowflake",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<Snowflake output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "<source type>"
            },
            "sink": {
                "type": "SnowflakeSink",
                "importSettings": {
                    "type": "SnowflakeImportCopyCommand",
                    "copyOptions": {
                        "FORCE": "TRUE",
                        "ON_ERROR": "SKIP_FILE"
                    },
                    "fileFormatOptions": {
                        "DATE_FORMAT": "YYYY-MM-DD"
                    }
                }
            }
        }
    }
]
阶段性复制到 Snowflake
如果您的源数据存储或格式与 Snowflake 的 COPY 命令不兼容(如上一节所述),请使用临时的 Azure Blob 存储实例来启用内置的暂存复制。 分阶段复制功能还能够提供更高的吞吐量。 该服务会自动转换数据,以满足 Snowflake 的数据格式要求。 然后,它会调用 COPY 命令将数据载入 Snowflake。 最后,它会从 Blob 存储中清理临时数据。 若要详细了解如何通过暂存方式复制数据,请参阅暂存复制。
若要使用此功能,请创建Azure Blob 存储链接服务,该服务将Azure存储帐户称为临时暂存。 然后,在复制活动中指定 enableStaging 和 stagingSettings 属性。
注意
临时 Azure Blob 存储的链接服务需要使用共享访问签名身份验证,这是 Snowflake COPY 命令的要求。
示例:
"activities":[
    {
        "name": "CopyToSnowflake",
        "type": "Copy",
        "inputs": [
            {
                "referenceName": "<input dataset name>",
                "type": "DatasetReference"
            }
        ],
        "outputs": [
            {
                "referenceName": "<Snowflake output dataset name>",
                "type": "DatasetReference"
            }
        ],
        "typeProperties": {
            "source": {
                "type": "<source type>"
            },
            "sink": {
                "type": "SnowflakeSink",
                "importSettings": {
                    "type": "SnowflakeImportCopyCommand"
                }
            },
            "enableStaging": true,
            "stagingSettings": {
                "linkedServiceName": {
                    "referenceName": "MyStagingBlob",
                    "type": "LinkedServiceReference"
                },
                "path": "mystagingpath"
            }
        }
    }
]
映射数据流属性
在映射数据流中转换数据时,可以从 Snowflake 中的表读取数据以及将数据写入表中。 有关详细信息,请参阅映射数据流中的源转换和汇聚转换。 可以选择使用 Snowflake 数据集或内联数据集作为源和接收器类型。
源转换
下表列出了 Snowflake 源支持的属性。 你可以在“源选项”选项卡中编辑这些属性。该连接器利用 Snowflake 内部数据传输。
| 名称 | 描述 | 必需的 | 允许的值 | 数据流脚本属性 |
|---|---|---|---|---|
| 表 | 如果选择“表”作为输入,则在使用内联数据集时,数据流会从在 Snowflake 数据集或源选项中指定的表中获取所有数据。 | 否 | 字符串 | (仅适用于内联数据集) 表名称 模式名称 |
| 查询 | 如果选择“查询”作为输入,请输入用于从 Snowflake 中提取数据的查询。 此设置会替代在数据集中选择的任何表。 如果架构、表和列的名称包含小写字母,请在查询中引用对象标识符,例如 select * from "schema"."myTable"。 |
否 | 字符串 | 查询 |
| 启用增量提取(预览) | 使用此选项指示 ADF 只处理自上次管道执行后发生变化的行。 | 否 | 布尔 | 启用Cdc |
| 增量列 | 使用增量提取功能时,必须选择用作源表水印的日期、时间或数字列。 | 否 | 字符串 | 水印列 |
| 启用 Snowflake 变更跟踪(预览版) | 此选项使 ADF 能够利用 Snowflake 更改数据捕获技术,仅处理上次管道执行以来的增量数据。 此选项通过行插入、更新和删除操作自动加载增量数据,而无需任何增量列。 | 否 | 布尔 | enableNativeCdc |
| 净更改 | 在使用 Snowflake 更改跟踪时,可以使用此选项获取去重的更改行或完整的更改。 去重后的更改行将仅显示自给定时间点以来已更改行的最新版本,而详尽更改会展示每个已更改行的所有版本,包括已删除或更新的版本。 例如,如果更新行,你将在详尽更改中看到删除版本和插入版本,但在已删除重复数据的更改行中只会看到插入版本。 根据你的用例,你可以选择适合你的需求的选项。 默认选项为 false,这意味着详尽的更改。 | 否 | 布尔 | 净变化 |
| 包括系统列 | 使用 snowflake 更改跟踪时,可以使用 systemColumns 选项来控制是将 Snowflake 提供的元数据流列包括在更改跟踪输出中还是排除。 默认情况下,systemColumns 被设置为 true,这意味着会包含元数据流列。 如果要排除 systemColumns,可以将它们设置为 false。 | 否 | 布尔 | systemColumns |
| 从头开始读取 | 使用增量提取和更改跟踪设置此选项后,将指示 ADF 在首次执行具有增量提取的管道时读取所有行。 | 否 | 布尔 | 跳过初始加载 |
Snowflake 源脚本示例
使用 Snowflake 数据集作为源类型时,关联的数据流脚本为:
source(allowSchemaDrift: true,
	validateSchema: false,
	query: 'select * from MYTABLE',
	format: 'query') ~> SnowflakeSource
如果使用内联数据集,则关联的数据流脚本为:
source(allowSchemaDrift: true,
	validateSchema: false,
	format: 'query',
	query: 'select * from MYTABLE',
	store: 'snowflake') ~> SnowflakeSource
原生更改跟踪
Azure 数据工厂(Azure资料工厂)现在支持 Snowflake 中称为更改跟踪的原生功能,使用日志记录以跟踪更改。 Snowflake 的此功能允许我们跟踪数据随时间推移的变化,使其可用于增量数据加载和审核目的。 为了利用此功能,当你启用变更数据捕获并选择 Snowflake 更改跟踪时,我们将为源表创建一个 Stream 对象,该对象在源 Snowflake 表上启用更改跟踪。 随后,我们在查询中使用 CHANGES 子句从源表中仅提取新的或更新的数据。 此外,建议计划管道,以便在 Snowflake 源表的数据保留时间设置的时间间隔内使用更改,否则用户可能会在捕获的更改中看到不一致的行为。
接收器转换
下表列出了 Snowflake 接收器支持的属性。 可以在“设置”选项卡中编辑这些属性。使用内联数据集时,你会看到其他设置,这些设置与数据集属性部分所述的属性相同。 该连接器利用 Snowflake 内部数据传输。
| 名称 | 描述 | 必需的 | 允许的值 | 数据流脚本属性 |
|---|---|---|---|---|
| 更新方法 | 指定 Snowflake 目标上允许哪些操作。 若要更新、更新插入或删除行,需要进行“更改行”转换才能标记这些操作的行。 |
是 |
true 或 false |
可删除 insertable updateable 可插入更新的 |
| 键列 | 对于更新、更新插入和删除操作,必须设置一个或多个键列,以确定要更改的行。 | 否 | 数组 | 密钥 |
| 表操作 | 确定在写入之前是否从目标表重新创建或删除所有行。 - 无:不会对表进行任何操作。 - 重新创建:将删除表并重新创建表。 创建新表时,如果是动态创建,这是必需的。 - 截断:将删除目标表中的所有行。 |
否 |
true 或 false |
重新创造 截断 |
Snowflake 接收器脚本示例
使用 Snowflake 数据集作为接收器类型时,关联的数据流脚本为:
IncomingStream sink(allowSchemaDrift: true,
	validateSchema: false,
	deletable:true,
	insertable:true,
	updateable:true,
	upsertable:false,
	keys:['movieId'],
	format: 'table',
	skipDuplicateMapInputs: true,
	skipDuplicateMapOutputs: true) ~> SnowflakeSink
如果使用内联数据集,则关联的数据流脚本为:
IncomingStream sink(allowSchemaDrift: true,
	validateSchema: false,
	format: 'table',
	tableName: 'table',
	schemaName: 'schema',
	deletable: true,
	insertable: true,
	updateable: true,
	upsertable: false,
	store: 'snowflake',
	skipDuplicateMapInputs: true,
	skipDuplicateMapOutputs: true) ~> SnowflakeSink
查询下推优化
通过将管道日志记录级别设置为“无”,我们排除了中间转换指标的传输,防止 Spark 优化的潜在障碍,并启用 Snowflake 提供的查询下推优化。 这种下推优化为具有大量数据集的大型 Snowflake 表提供了实质性的性能增强。
注意
我们不支持 Snowflake 中的临时表,因为它们是会话或创建它们的用户的本地表,因此其他会话无法访问它们,并且容易被 Snowflake 覆盖为常规表。 虽然Snowflake提供了可全局访问的临时表作为替代方案,但它们需要手动删除,这与我们使用临时表的主要目标(即避免在源架构中进行任何删除操作)相矛盾。
Snowflake V1 的数据类型映射
从 Snowflake 复制数据时,使用以下映射从 Snowflake 数据类型以内部方式映射到服务中的临时数据类型。 若要了解复制活动如何将源架构和数据类型映射到接收器,请参阅架构和数据类型映射。
| Snowflake 数据类型 | 服务过渡数据类型 |
|---|---|
| 数字(p,0) | Int64 |
| NUMBER (p,s,当 s>0 时) | 十进制 |
| 漂浮 | 加倍 |
| VARCHAR | 字符串 |
| 煳 | 字符串 |
| 二进制 | 字节[] |
| 布尔型 | 布尔 |
| 日期 | 日期时间 |
| 时间 | TimeSpan(时间跨度) |
| TIMESTAMP_LTZ | 日期时间 |
| TIMESTAMP_NTZ | 日期时间 |
| TIMESTAMP_TZ | 日期时间 |
| 变体 | 字符串 |
| 对象 | 字符串 |
| 数组 | 字符串 |
查找活动属性
有关属性的详细信息,请参阅查找活动。
相关内容
有关 复制活动 支持的作为源和汇的数据存储的列表,请参阅 支持的数据存储和格式。