Important
MLflow 系统表以 公共预览版提供。
系统 mlflow 表捕获 MLflow 跟踪服务中管理的试验元数据。 这些表允许特权用户充分利用 Databricks lakehouse 工具集,对区域内所有工作区的 MLflow 数据进行处理。 可以使用这些表生成自定义 AI/BI 仪表板、设置 SQL 警报或执行大规模分析查询。
mlflow通过系统表,用户可以回答如下问题:
- 哪些试验的可靠性最低?
- 不同试验的平均 GPU 利用率是多少?
注释
系统 mlflow 表于 2025 年 9 月 2 日开始记录来自所有区域的 MLflow 数据。 该日期之前的数据可能不可用。
可用表
该 mlflow 架构包括下表:
-
system.mlflow.experiments_latest:记录试验名称和软删除事件。 此数据类似于 MLflow UI 中的 试验页 。 -
system.mlflow.runs_latest:记录运行生命周期信息、与每个运行关联的参数和标记,以及所有指标的最小、最大值和最新值的聚合统计信息。 此数据类似于 运行搜索或运行详情页面。 -
system.mlflow.run_metrics_history:记录在运行中记录的所有指标的名称、值、时间戳和步骤,该指标可用于绘制运行中的详细时间。 此数据类似于 “运行详细信息”页上的“指标”选项卡。
下面是使用仪表板绘制运行信息的示例:

表架构
下面是包含说明和示例数据的表架构。
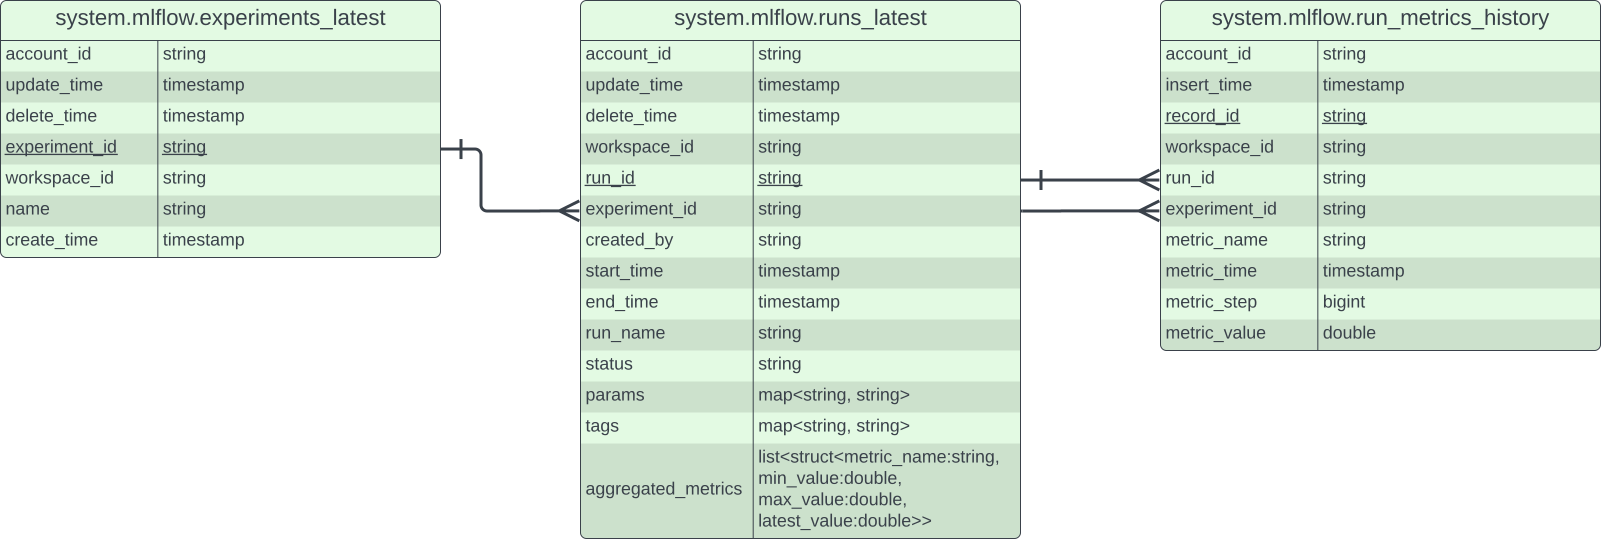
system.mlflow.experiments_latest
| 列名称 | 数据类型 | Description | 示例 | 可为 Null |
|---|---|---|---|---|
account_id |
字符串 | 包含 MLflow 试验的帐户的 ID | "bd59efba-4444-4444-443f-44444449203" |
否 |
update_time |
时间戳 | 上次更新试验的系统时间 | 2024-06-27T00:58:57.000+00:00 |
否 |
delete_time |
时间戳 | 用户执行对 MLflow 实验进行软删除操作时的系统时间 | 2024-07-02T12:42:59.000+00:00 |
是 |
experiment_id |
字符串 | MLflow 实验的 ID | "2667956459304720" |
否 |
workspace_id |
字符串 | 包含 MLflow 试验的工作区的 ID | "6051921418418893" |
否 |
name |
字符串 | 试验的用户提供的名称 | "/Users/first.last@databricks.com/myexperiment" |
否 |
create_time |
时间戳 | 创建试验的系统时间 | 2024-06-27T00:58:57.000+00:00 |
否 |
system.mlflow.runs_latest
| 列名称 | 数据类型 | Description | 示例 | 可为 Null |
|---|---|---|---|---|
account_id |
字符串 | 包含 MLflow 运行的帐户的 ID | "bd59efba-4444-4444-443f-44444449203" |
否 |
update_time |
时间戳 | 运行上次更新时的系统时间 | 2024-06-27T00:58:57.000+00:00 |
否 |
delete_time |
时间戳 | 用户软删除 MLflow 运行的系统时间 | 2024-07-02T12:42:59.000+00:00 |
是 |
workspace_id |
字符串 | 包含 MLflow 运行的工作区的 ID | "6051921418418893" |
否 |
run_id |
字符串 | MLflow 运行的 ID | "7716d750d279487c95f64a75bff2ad56" |
否 |
experiment_id |
字符串 | 包含 MLflow 运行的 MLflow 实验 ID | "2667956459304720" |
否 |
created_by |
字符串 | 创建 MLflow 运行的 Databricks 主体、用户或组的名称 | "<user>@<domain-name>" |
是 |
start_time |
时间戳 | MLflow 运行启动时的用户指定时间 | 2024-06-27T00:58:57.000+00:00 |
否 |
end_time |
时间戳 | MLflow 运行结束的用户指定时间 | 2024-07-02T12:42:59.000+00:00 |
是 |
run_name |
字符串 | MLflow 运行的名称 |
"wistful-deer-932"、"my-xgboost-training-run" |
否 |
status |
字符串 | MLflow 运行的执行状态 | "FINISHED" |
否 |
params |
映射<string, string> | MLflow 运行中的键值参数 | {"n_layers": "5", "batch_size": "64", "optimizer": "Adam"} |
否 |
tags |
映射<string, string> | 在 MLflow 运行时设置的键值标记 | {"ready_for_review": "true"} |
否 |
aggregated_metrics |
list<结构<字符串, double, double, double>> | 汇总run_metrics_history中的指标的聚合视图 | [{"metric_name": "training_accuracy", "latest_value": 0.97, "min_value": 0.8, "max_value": 1.0}, ...] |
否 |
aggregated_metrics.metric_name |
字符串 | 指标的用户指定名称 | "training_accuracy" |
否 |
aggregated_metrics.latest_value |
翻倍 | 此(运行,metric_name)组合在run_metrics_history的时间序列中的metric_name的最新值 | 0.97 |
否 |
aggregated_metrics.max_value |
翻倍 | 在run_metrics_history中,此(运行, metric_name)组合的时间序列中metric_name的最大值。 如果为指标记录了任何 NaN 值,该值将为 NaN | 1.0 |
否 |
aggregated_metrics.min_value |
翻倍 | 在 run_metrics_history 中,(运行, metric_name) 组合的时间序列中的 metric_name 的最小值。 如果为指标记录了任何 NaN 值,该值将为 NaN | 0.8 |
否 |
system.mlflow.run_metrics_history
| 列名称 | 数据类型 | Description | 示例 | 可为 Null |
|---|---|---|---|---|
account_id |
字符串 | 包含记录指标的 MLflow 运行的帐户的 ID | "bd59efba-4444-4444-443f-44444449203" |
否 |
insert_time |
时间戳 | 插入指标的系统时间 | 2024-06-27T00:58:57.000+00:00 |
否 |
record_id |
字符串 | 用于区分相同值的指标的唯一标识符 | "Ae1mDT5gFMSUwb+UUTuXMQ==" |
否 |
workspace_id |
字符串 | 包含记录指标的 MLflow 运行所在工作区的 ID | "6051921418418893" |
否 |
experiment_id |
字符串 | 包含记录指标的 MLflow 运行的 MLflow 试验的 ID | "2667956459304720" |
否 |
run_id |
字符串 | 记录指标的 MLflow运行ID | "7716d750d279487c95f64a75bff2ad56" |
否 |
metric_name |
字符串 | 指标名称 | "training_accuracy" |
否 |
metric_time |
时间戳 | 计算指标时的用户指定时间 | 2024-06-27T00:55:54.1231+00:00 |
否 |
metric_step |
bigint | 记录指标的模型训练或代理开发过程中的步骤(例如,训练迭代) | 10 |
否 |
metric_value |
翻倍 | 指标值 | 0.97 |
否 |
与用户共享访问权限
默认情况下,只有帐户管理员有权访问系统架构。 若要向其他用户授予对表的访问权限,帐户管理员必须向其授予对架构的 system.mlflow. USE 和 SELECT 权限。 请参阅 Unity Catalog 权限参考。
有权访问这些表的任何用户都可以查看帐户中所有工作区的所有 MLflow 试验中的元数据。 若要为给定组而不是单个用户配置表访问权限,请参阅 Unity 目录最佳做法。
如果需要比授予所有用户对表的访问权限更精细的控制,则可以使用具有自定义条件的 动态视图 来授予组特定访问权限。 例如,可以创建一个仅显示来自特定试验 ID 集的记录的视图。 配置自定义视图后,向用户提供视图的名称,以便他们可以直接查询动态视图,而不是系统表。
注释
不能直接将 MLflow 试验权限 与 Unity 目录权限同步。
MLflow 元数据的示例用例
以下部分提供了如何使用 MLflow 系统表回答有关 MLflow 试验和运行的问题的示例。
为低试验可靠性配置 SQL 警报
使用 Databricks SQL 警报,可以计划定期定期查询,并在不再满足某些约束时收到通知。
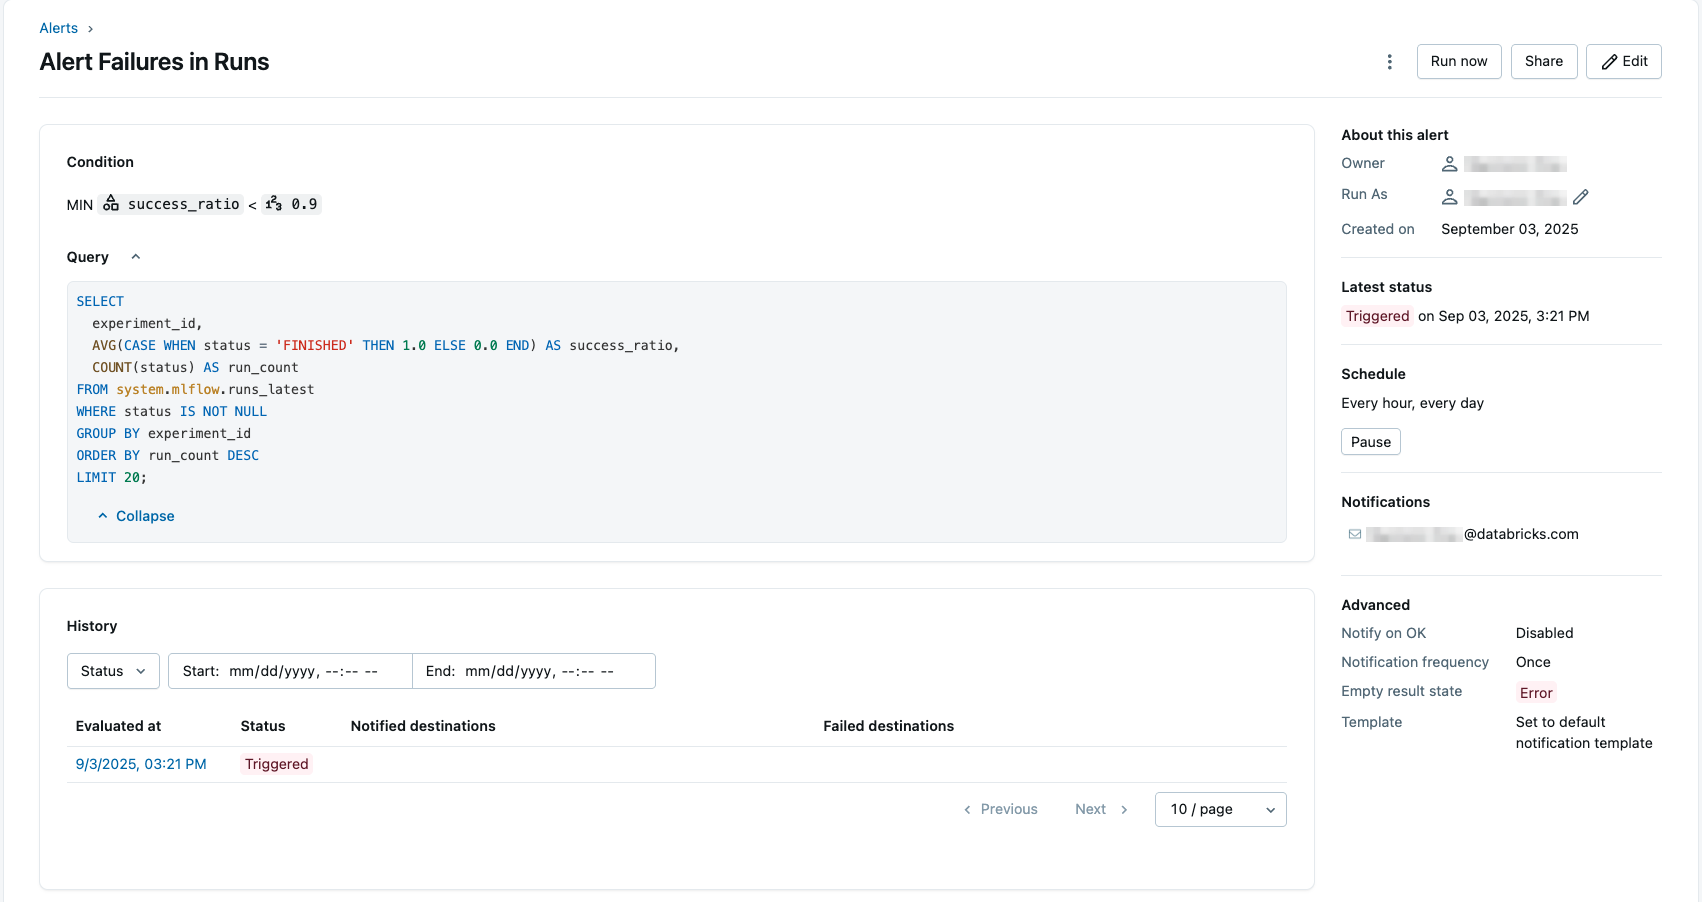
此示例创建一个警报,用于检查工作区中最常运行的实验,以确定它们是否存在低可靠性问题,并且可能需要特别注意。 查询使用 runs_latest 表计算每个标记为已完成的试验的运行数,除以运行总数。
注释
还可以使用 旧警报。
单击边栏中的
 警报,然后单击“ 创建警报”。
在查询编辑器中复制并粘贴以下查询。
 SELECT
   experiment_id,
   AVG(CASE WHEN status = 'FINISHED' THEN 1.0 ELSE 0.0 END) AS success_ratio,
   COUNT(status) AS run_count
 FROM system.mlflow.runs_latest
 WHERE status IS NOT NULL
 GROUP BY experiment_id
 ORDER BY run_count DESC
 LIMIT 20;
在 “条件” 字段中,将条件设置为
MIN success_ratio < 0.9。 如果前 20 个试验(按运行次数)中的任意一个成功率小于 90%,这将触发警报。
此外,还可以测试条件、设置计划和配置通知。 有关配置警报的详细信息,请参阅 设置 SQL 警报。 下面是使用查询的示例配置。
示例查询
可以使用以下示例查询来获取有关使用 Databricks SQL 的帐户中的 MLflow 活动的信息。 还可以通过 Spark 利用 Python 笔记本等工具。
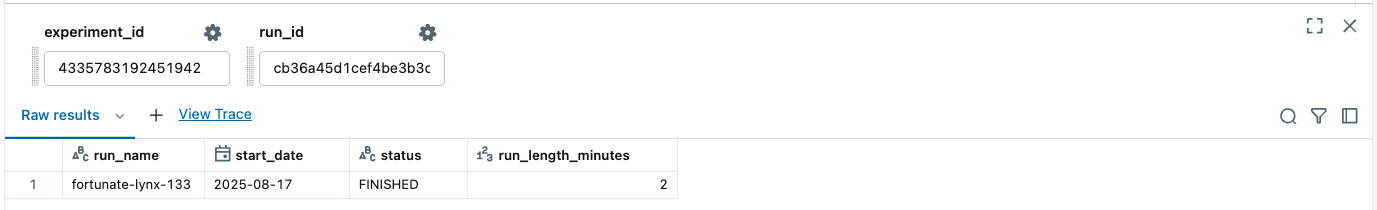
从 runs_latest 获取运行信息
SELECT
  run_name,
  date(start_time) AS start_date,
  status,
  TIMESTAMPDIFF(MINUTE, start_time, end_time) AS run_length_minutes
FROM system.mlflow.runs_latest
WHERE
  experiment_id = :experiment_id
  AND run_id = :run_id
LIMIT 1
这会返回有关给定运行的信息:
从 experiments_latest 和 runs_latest 获取试验和运行信息
SELECT
  runs.run_name,
  experiments.name,
  date(runs.start_time) AS start_date,
  runs.status,
  TIMESTAMPDIFF(MINUTE, runs.start_time, runs.end_time) AS run_length_minutes
FROM system.mlflow.runs_latest runs
  JOIN system.mlflow.experiments_latest experiments ON runs.experiment_id = experiments.experiment_id
  WHERE
    runs.experiment_id = :experiment_id
    AND runs.run_id = :run_id
LIMIT 1
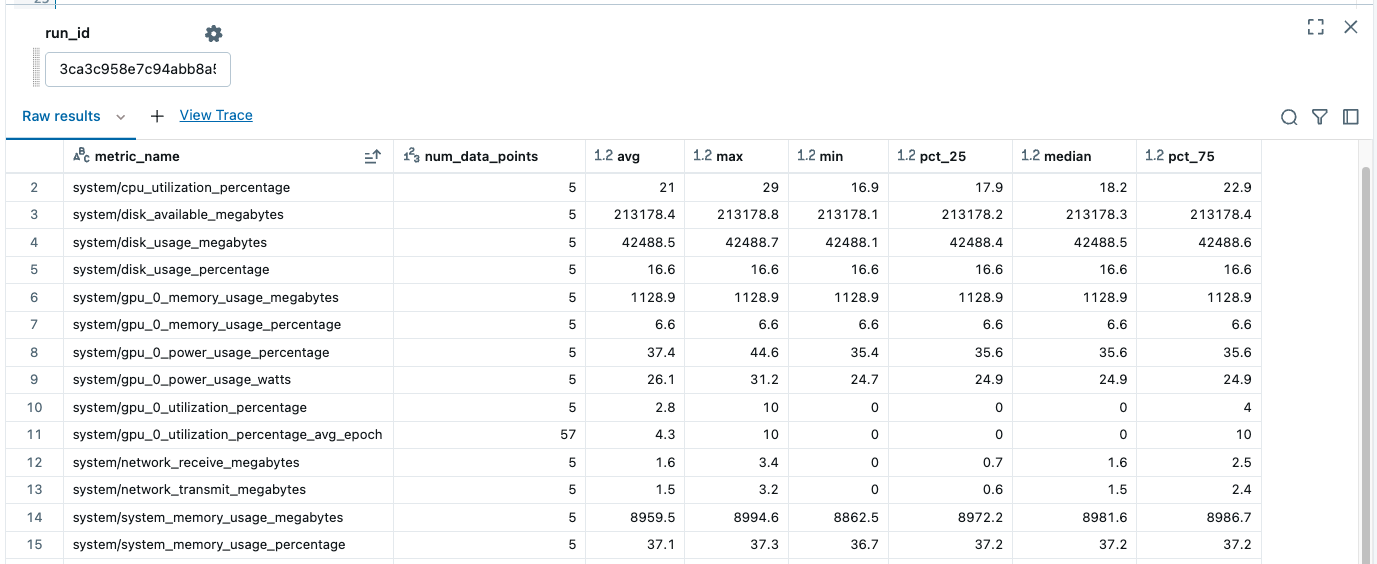
获取给定运行的摘要统计信息 run_metrics_history
SELECT
  metric_name,
  count(metric_time) AS num_data_points,
  ROUND(avg(metric_value), 1) AS avg,
  ROUND(max(metric_value), 1) AS max,
  ROUND(min(metric_value), 1) AS min,
  ROUND(PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY metric_value), 1) AS pct_25,
  ROUND(PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY metric_value), 1) AS median,
  ROUND(PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY metric_value), 1) AS pct_75
FROM
  system.mlflow.run_metrics_history
WHERE
  run_id = :run_id
GROUP BY
  metric_name, run_id
LIMIT 100
这会返回给定 run_id指标的摘要:
试验和运行的仪表板
可以基于 MLflow 系统表的数据构建 仪表板,以分析整个工作区中的 MLflow 实验和运行。
有关详细信息,请参阅 在系统表中使用 MLflow 元数据生成仪表板