GPU 分析火焰图显示哪些函数消耗了最多的 GPU 内存。 本文介绍如何解释 GPU 分析工具为Azure Kubernetes 服务 (AKS)生成的火焰图。
Important
AKS 预览功能可在自助服务和自愿选择的基础上启用。 预览版按“现状”和“视供应情况”提供,它们不包括在服务级别协议和有限保证范围内。 AKS 预览功能是由客户支持尽最大努力部分覆盖。 因此,这些功能并不适合用于生产。 有关详细信息,请参阅以下支持文章:
在开始之前, 请设置 GPU 分析 并确认分析数据在Pyoscope 和 Grafana 中可用。
注释
在分析器分析工作负载并解析符号期间,第一次分析运行可能不会显示所有符号,包括模型加载等启动操作中的符号。 在初始分析后再次运行工作负载,以便在后续生成的性能分析结果中捕获这些符号。
了解火焰图
火焰图将性能分析得到的调用栈可视化。 每个条形表示一个函数,堆叠条形显示调用链,即哪个函数调用了另一个函数。 每个条形图的宽度表示流经该函数的测量资源量,例如 CPU 时间或分配的 GPU 内存。
关键规则:条形越宽,测量的资源越流过该函数。
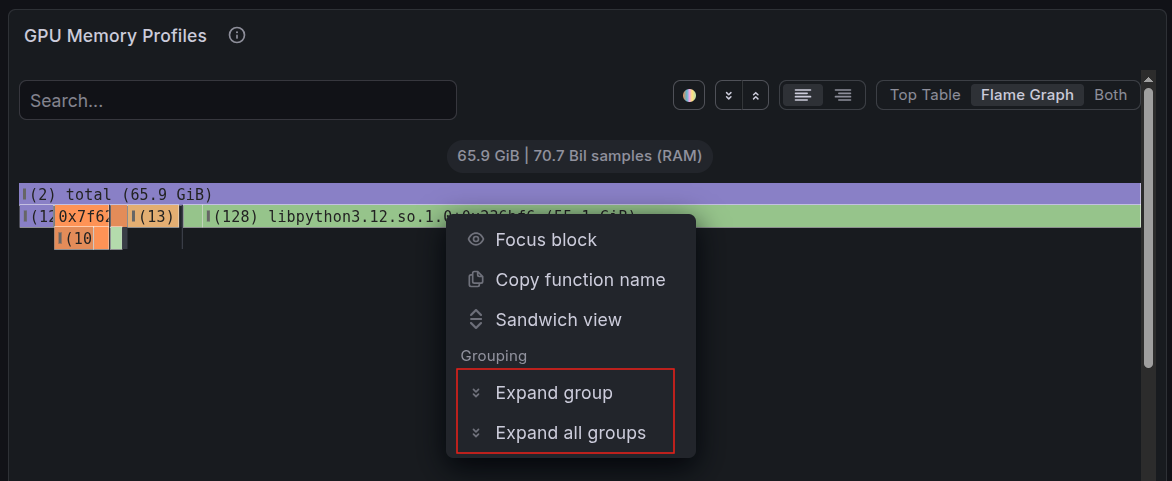
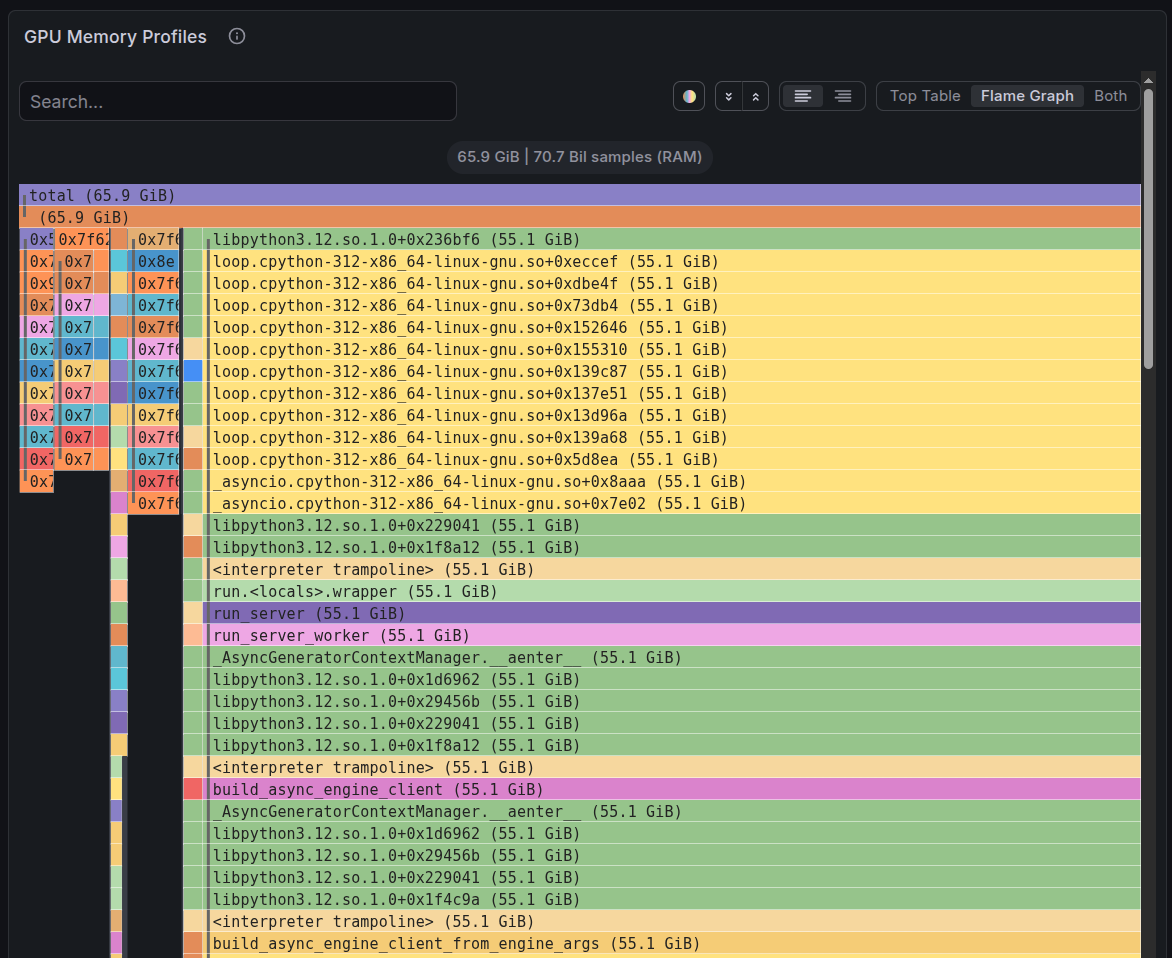
以下示例火焰图是从 vLLM 推理工作负载捕获的。
Tip
在 Grafana 的火焰图面板中,使用 “展开所有组” 可查看完整的调用堆栈,无需折叠。 使用 “搜索 ”框查找特定函数或关键字。 若要防止面板再次折叠,请在检查已展开的火焰图时,将 Grafana 仪表板右上角的刷新间隔设置为 Off,以暂停仪表板自动刷新。
Tip
使用 焦点块 专注于特定的分配路径。
读取符号
火焰图标签遵循以下约定:
| 符号格式 | Meaning |
|---|---|
Foo > bar |
class Foo: method def bar() |
Foo > __init__ |
类 Foo 的构造函数 |
bar (单独) |
独立的 def bar() 函数 |
<interpreter trampoline> |
CPython 开销。 可以忽略此符号。 |
<raw-address>,例如,0x7f151 |
没有可用 Python 符号的原生 C 或 CUDA 代码。 |
示例包括:
-
GPUModelRunner/_allocate_kv_cache_tensors:类中的方法。 将此符号读作class GPUModelRunner: def _allocate_kv_cache_tensors(self). -
LlamaMLP/__init__:创建对象时调用的LlamaMLP(...)构造函数。 -
_compile_fx_inner:不在类内部的独立模块级函数。
了解自身分配与总分配的区别
使用 “自我 ”和 “总计 ”值来确定资源的使用位置:
- 总计 是函数消耗的资源及其调用的所有内容。 某个函数的总量可能很大,但它自身并不分配任何内存,因为它只是调用链中的一环。
- 自我 是函数直接消耗的资源,不包括其子函数。 较高的自我值意味着此函数是资源消耗的位置。
例如,如果 GPUModelRunner._allocate_kv_cache_tensors 具有 55.1 GB 的自分配,则它是调用 torch.empty() 创建键值(KV)缓存张量的函数。
使用以下导航技术:
- 从叶节点开始,这些节点是上面没有任何条形的条形图。 其整个宽度表示自我分配。
- 搜索分配来源时,跳过自身分配为零的宽条。 这些函数协调对其他函数的调用。
- 检查自身分配较高的宽条形,以将其作为潜在的优化目标。
查找最大的资源使用者
使用以下步骤识别热点:
看图表顶部最宽的条。 这些叶函数分配内存。 条形越宽,消耗的内存就越大。
检查自身分配量与总分配量。 底部带有
self: 0的宽条是调用链的一部分。 沿着它向上查找,直到找到一个自身分配量较高的条目。从下到上读取调用堆栈,了解调用函数的原因。 以下示例以执行分配的函数结尾:
<raw-address>, for example, 0x7f151       -> native code entry
<interpreter trampoline>                 -> CPython dispatch
<module>                                 -> script top level
EngineCoreProc.run_engine_core           -> vLLM engine startup
EngineCore.__init__                      -> engine initialization
EngineCore._initialize_kv_caches         -> KV cache setup
Worker.initialize_from_config            -> worker setup
GPUModelRunner.initialize_kv_cache       -> model runner
GPUModelRunner._allocate_kv_cache_tensors -> actual allocation
使用下表作为快速参考:
| 目标 | 应该注意什么 |
|---|---|
| 查找分配最多内存的内容 | 堆栈顶部最宽的叶条 |
| 查找占用内存最多的内容 | 位于堆栈底部的最宽条形 |
| 确定优化目标 | 自动分配宽度较宽的条形图 |
| 标识可以跳过的函数 | 自身分配为零的宽条形 |