当一个阶段大部分时间都在读取数据时,先找出它读取了哪个表或文件,再进行优化读取。 阶段页面显示一个阶段读取了多少数据,但不会显示数据来源。 SQL DAG 将阶段连接到读取数据的扫描。
当最长阶段具有高输入量时,请使用此页面。 如果阶段输入不高,请检查其输出,并检查是否在 Spark 阶段高 I/O 中发生 shuffle,同时利用本指南的其他页面诊断问题。 请参见 使用 Spark UI 诊断成本和性能问题。
进入 DAG
要找到读取数据的扫描结果:
在作业页面,注意执行读取的阶段ID。 在这个例子中,阶段ID是194:

滚动到职位页面顶部,点击 关联SQL查询:
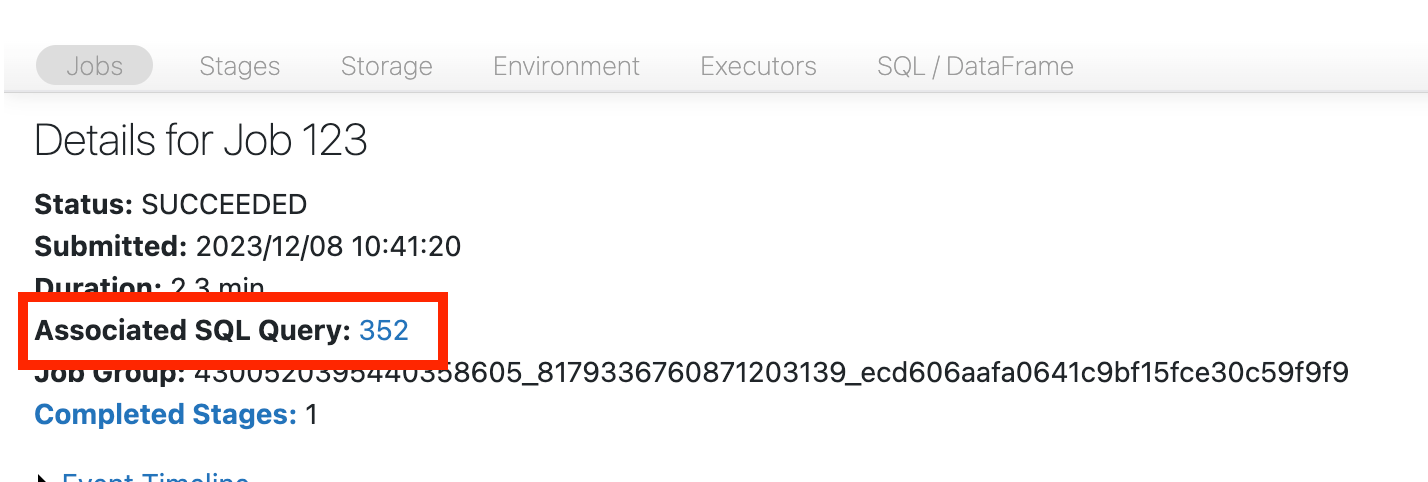
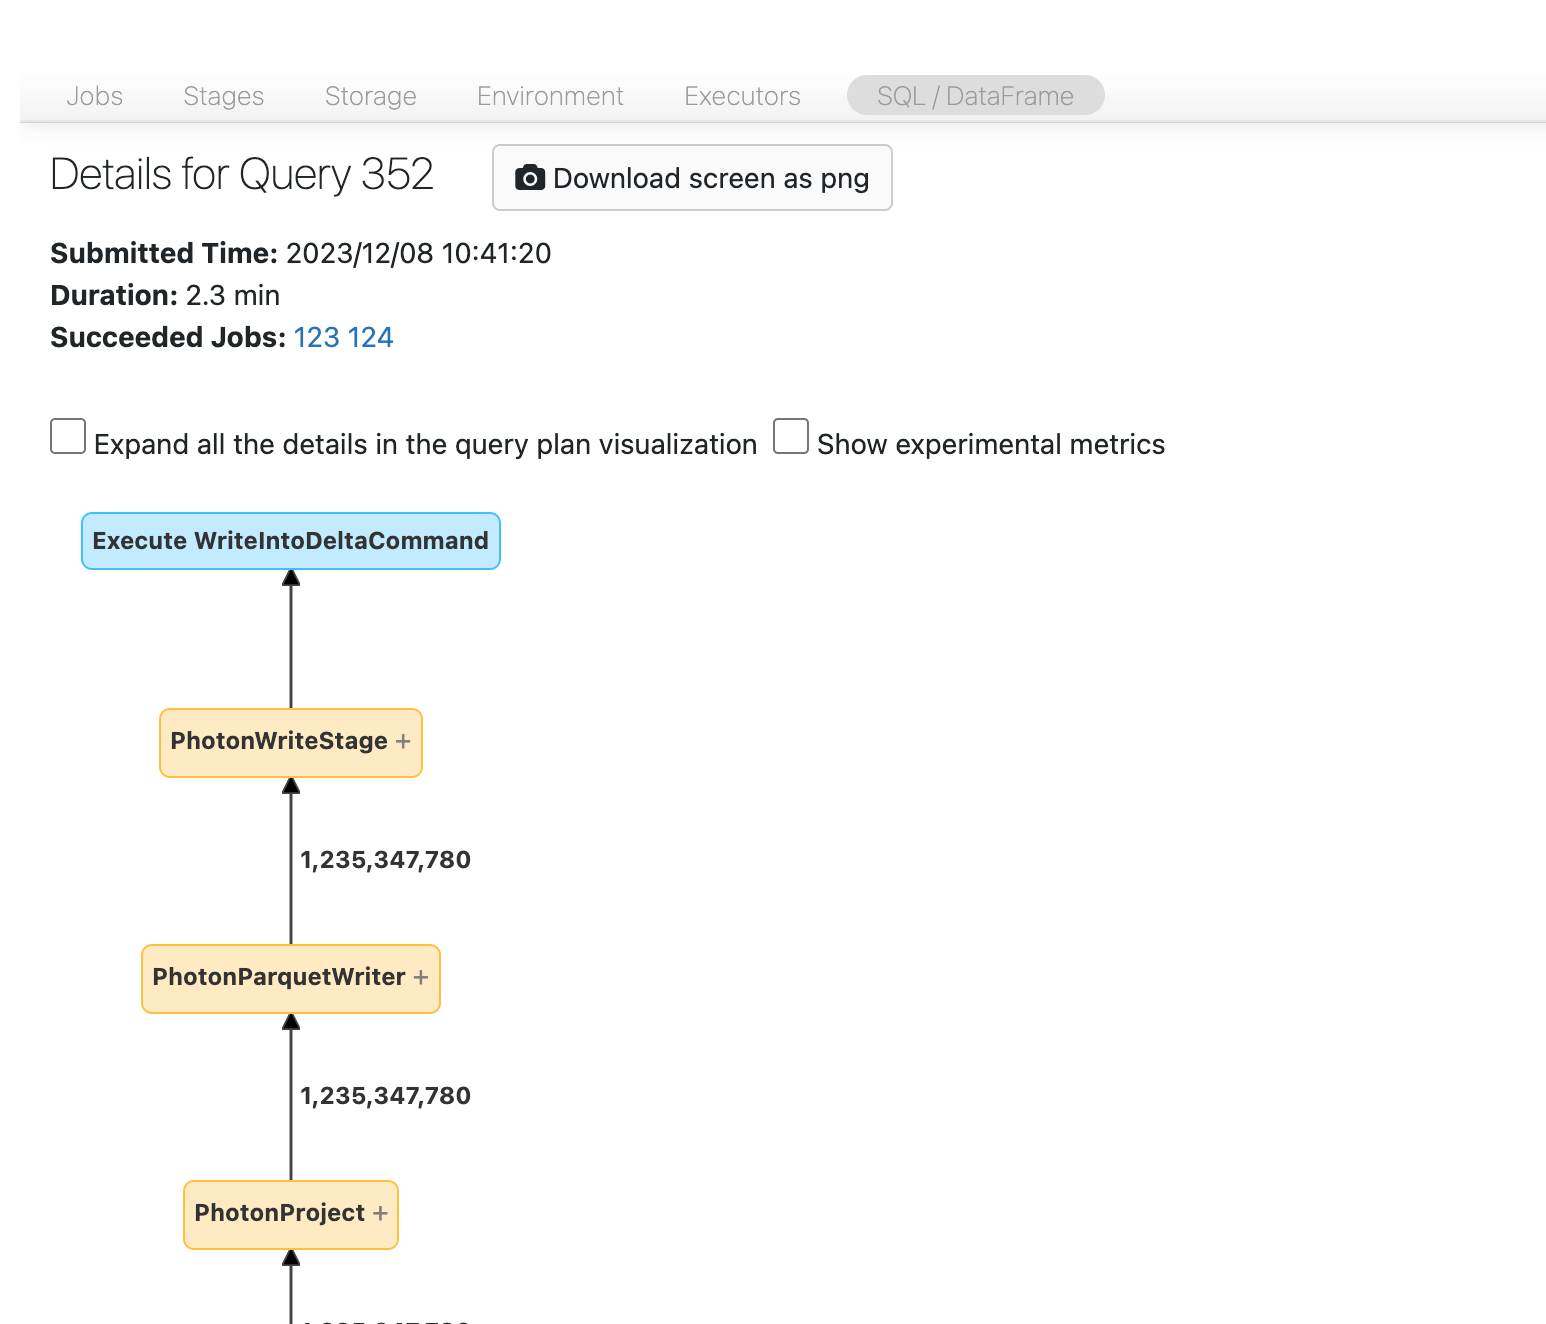
SQL DAG 出现了。 如果没有,请滚动查找:
在DAG中找到阶段。 如果 DAG 没有明确说明数据源,请寻找标有你记下的阶段 ID 的节点:
在 DAG 中的
SQL 阶段 找到该阶段的 扫描 节点。 在这个例子中,该阶段读取一个名为
transactions的表:DAG 中的
扫描 要查看节点读取的数据位置,请点击或悬停在节点上。
后续步骤
确定阶段读取的数据后,选择一种方法来减少或加快读取速度。 参见 高电平输入。