某个阶段可能因为处理的数据超过了集群在可用时间内能读取、写入或混洗的数据量。 要修复 I/O 密集型阶段:
减少该阶段处理的数据量。
加快 Stage 的读写速度。
增加计算容量。
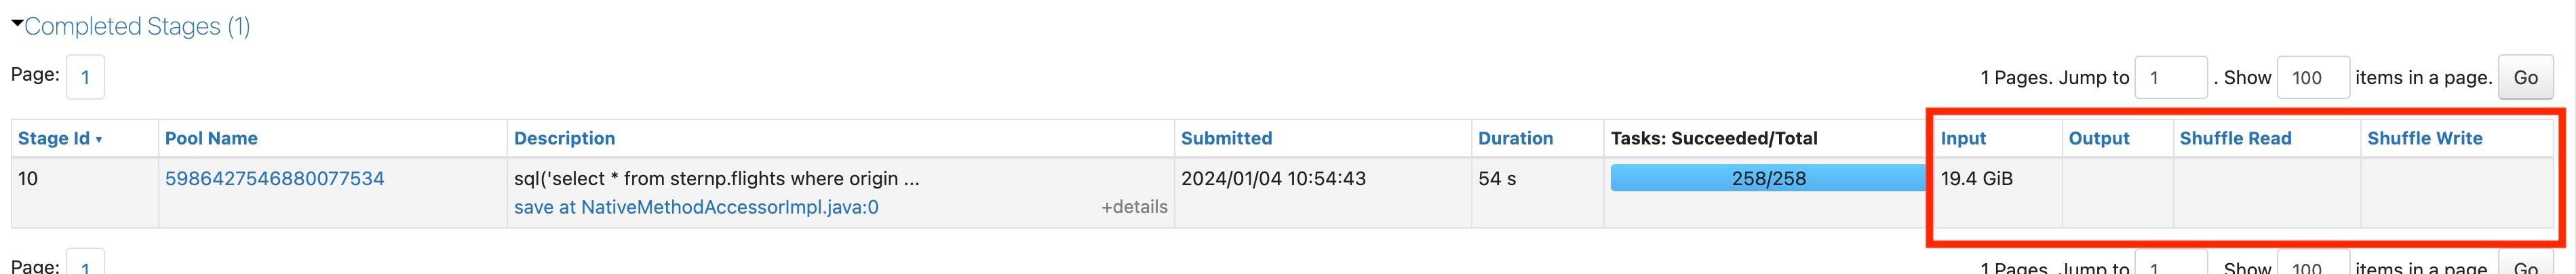
在排除耗时最长的阶段中的 倾斜和溢出 后,使用本页。 阶段的输入/输出列显示该阶段是否受 I/O 限制,如果是,瓶颈是输入、输出还是混洗。
查看最长阶段的 I/O 列:
什么是高输入/输出?
每个CPU核心的读写速度约为每秒3 MB。 要检查某阶段的I/O是否高,可以比较其每核心吞吐量与该速率:
找到该阶段I/O列中最高的值。
将该数值除以所有工作单元的CPU核心总数。
将结果除以以秒为单位的阶段持续时间。
如果结果大约是每秒 3 MB,则该阶段可能受 I/O 限制。
高输入
如果输入列较大,阶段会花费大量时间读取数据。 要查找阶段读取的是哪个表或哪些文件,请参见 识别 SQL DAG 中代价高昂的读取。 然后尝试以下方法加快阅读速度:
将数据存储在 Delta 表中。
启用 Photon,它可以加快读取速度,尤其是宽表时。
让查询更具选择性,这样读取的数据更少。
重新考虑数据布局,这样跳过数据会更高效。
如果阶段多次读取相同数据,使用 磁盘缓存。
如果阶段运行联接,检查是否适用 动态文件剪枝。
高输出
如果输出列很大,阶段会花大量时间写入数据。 试试以下方法:
减少返工。 要检查该阶段是否重写数据,请参见“判断 Spark 是否重写过多文件”。 如果阶段重写大量数据:
- 如果写操作是合并,就优化合并。
启用 Photon,可以加快写入速度。
高度随机排序
如果“Shuffle Read”或“Shuffle Write”列较大,该阶段会花大量时间在执行器之间 Shuffle 数据以进行连接或聚合。 为了减少洗牌时间,Databricks 建议将 spark.sql.shuffle.partitions 设置为 auto,使 Spark 根据查询计划和输入数据大小来设置洗牌分区数量。 参见 AQE 配置。
无高性能I/O
如果没有任何一个 I/O 列很大,该阶段速度慢是由其他原因造成的。 要找出原因,可以参见 Slow Spark 阶段,输入输出很少。