自动化机器学习(AutoML)记录训练作业期间创建的模型的指标和图表。 将这些结果一起使用来比较模型,选择操作阈值,并识别聚合分数可能隐藏的错误。
先决条件
- 一个 Azure 订阅。 如果没有帐户,请创建Azure帐户。
- 使用 Azure 机器学习工作室 或 Azure 机器学习 CLI 或 Python SDK 创建的 AutoML 作业。
选择评估结果
从与任务匹配的结果类型开始,然后使用互补指标和图表从不同的角度测试相同的行为。
| 任务 | 从...开始 | 补充 |
|---|---|---|
| 分类 | 分类指标 | 混淆矩阵 和 分类曲线 |
| 回归 | 回归指标 | 残差 和 预测值与实际值 |
| 预测 | 预测指标 | 逐个序列检查和 预测范围 |
| 图像模型 | 特定于任务的主要指标 | 图像模型结果 |
| 模型调试 | 聚合指标和图表 | 负责任的 AI 见解 |
以下指南可帮助你选择初始指标。 没有单个指标捕获每个模型行为。
| Scenario | 从...开始 | 补充 | 重要警告 |
|---|---|---|---|
| 不平衡分类 | 宏召回率、均衡准确性或 PR AUC | 混淆矩阵和每类精度和召回率 | 准确性和微平均值可以隐藏少数类故障。 |
| 正例排序 | ROC AUC 或 PR AUC | 特定阈值下的精确率和召回率 | AUC 不选择操作阈值。 |
| 概率质量 | 对数损失和校准曲线 | 准确率或 AUC | 校准良好的模型不一定准确。 |
| 含离群值的回归 | MAE 或中位绝对误差 | RMSE 和剩余直方图 | RMSE 对较大的误差赋予更大的权重。 |
| 相对回归错误 | MAPE,仅当实际值远离零时 | MAE 或 RMSE | 零和接近零的实际值使 MAPE 不可靠。 |
| 相对于尺度的非负目标 | RMSLE | RMSE 或 MAE | RMSLE 不支持负目标值或负预测值。 |
| 多序列预测 | 宏归一化指标 | 微观指标和按系列检查 | 高流量序列可能会主导微观指标。 |
| 模型调试 | 负责任的 AI 洞察 | 聚合指标和图表 | 集成的 AutoML 仪表板具有 工作流先决条件。 |
查看作业结果
AutoML 作业完成后,在工作室中查看其模型指标和图表:
- 登录到Azure 机器学习工作室并打开工作区。
- 选择Jobs。
- 选择实验,然后选择 AutoML 作业。
- 选择 模型,然后选择要评估的模型的 算法名称 。
- 选择 “指标”,然后使用复选框显示指标和图表。
若要以编程方式进行访问,请使用 SDK v2 MLClient.jobs 操作 或 日志,并使用 MLflow 查看指标。 如果您维护 SDK v1 代码,请参阅 升级到 SDK v2。 SDK v2 没有提供可直接替代 SDK v1 笔记本结果微件的对应项。
评估分类结果
选择分类指标
使用独立于阈值的指标(如 ROC AUC 和平均精度)比较决策阈值的排名。 使用准确率、精确率、召回率和 F1 在选定阈值下评估预测结果。 对于不平衡的数据,请检查宏或每类结果和混淆矩阵,而不是仅依赖于准确性或微平均值。 有关定义和实现详细信息,请参阅 scikit-learn 模型评估指南。
分类指标参考
AutoML 计算分类模型的以下指标。 确切的指标标识符以代码格式显示。
| 度量 | 它度量的内容 | 何时使用它 | 更好的价值 | Reference |
|---|---|---|---|---|
AUC_macro、、AUC_microAUC_weighted、、AUC_binary |
各决策阈值下的 ROC 曲线下面积。 它度量排名,而不是正确预测的比例。 | 比较模型将正样本排在负样本之前的效果。 | 更接近 1; 0.5 表示随机排名。 |
scikit-learn roc_auc_score 参考手册 |
accuracy |
与实际类别标签匹配的预测所占比例。 | 当各类别频率与错误成本大致均衡时使用。 | 离1更近。 |
scikit-learn accuracy_score 参考手册 |
average_precision_score_macro、、average_precision_score_microaverage_precision_score_weighted、、average_precision_score_binary |
按召回率每次增加对精度加权的精度-召回率曲线摘要。 | 比较正类较少见时的排序表现。 | 离1更近。 |
scikit-learn average_precision_score 参考手册 |
balanced_accuracy |
各类别召回率的未加权平均值。 | 在类别频率不同时比较模型。 | 离1更近。 |
scikit-learn balanced_accuracy_score 参考手册 |
f1_score_macro、、f1_score_microf1_score_weighted、、f1_score_binary |
精确率和召回率的调和平均数。 | 在不使用真负例的情况下平衡误报和漏报。 | 离1更近。 |
scikit-learn f1_score 参考手册 |
log_loss |
预测概率中实际标签的负对数可能性。 | 评估概率质量,并严厉惩罚高置信度的错误预测。 | 离0更近。 |
scikit-learn log_loss 参考手册 |
norm_macro_recall |
宏平均召回率经过调整后,平衡随机猜测时为 0,而完美召回率为 1。 当性能比随机基线差时,值可能是负值。 |
比较各类别的召回率,同时考虑到类别数量。 | 离1更近。 |
scikit-learn recall_score 参考手册 |
matthews_correlation |
实际类和预测类之间的相关性。 | 在各类别样本量不同时评估分类效果。 | 更接近 1; 0 表示随机预测和 -1 反预测。 |
scikit-learn matthews_corrcoef 参考手册 |
precision_score_macro、、precision_score_microprecision_score_weighted、、precision_score_binary |
预测的正数的份额: TP / (TP + FP). |
在误报代价高昂时使用。 | 离1更近。 |
scikit-learn precision_score 参考手册 |
recall_score_macro、、recall_score_microrecall_score_weighted、、recall_score_binary |
检测到的实际正数的份额: TP / (TP + FN)。 误报不会显示在召回中。 |
当假阴性的代价高昂时使用。 | 离1更近。 |
scikit-learn recall_score 参考手册 |
weighted_accuracy |
会改变每个类别对结果贡献的准确率。 | 当类别不平衡使普通准确率具有误导性时,对模型进行比较。 | 离1更近。 |
AutoML 分类指标指南 |
二进制和多类指标
对于K类,宏召回是每类召回的不加权平均值: macro_recall = (1 / K) * sum(recall_k) 因此,无论其样本数如何,每个类都有同等的影响。
微召回在计算结果前会先汇总计数:micro_recall = sum(TP) / (sum(TP) + sum(FN))。 它为每个样本提供相等的权重,因此大多数类可以占据主导地位。 在单标签多类分类中,微召回率等于整体准确性。 加权平均值计算每个类的指标,并按类支持对结果进行加权。 有关详细信息,请参阅 多类和多标签指标的 scikit-learn 指南。
AutoML 将归一化宏召回率计算为 (macro_recall - baseline) / (1 - baseline),其中均衡随机基线为 1 / K。 结果 1 完美, 0 是随机基线,负结果比该基线差。
对于二进制一对其余指标,请配置 Positive 类标签。
SDK v2 属性为 positive_label.
AutoML 将所有其他标签视为此计算的负数。 此选择会影响二进制精度、召回率、F1、AUC、平均精度和相关二进制指标。 它不会改变真实标签。
混淆矩阵
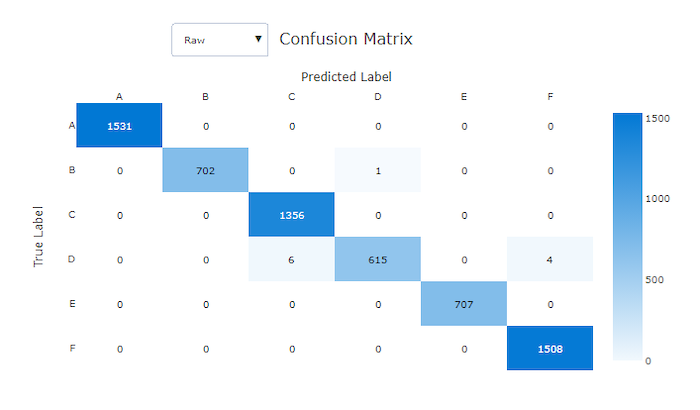
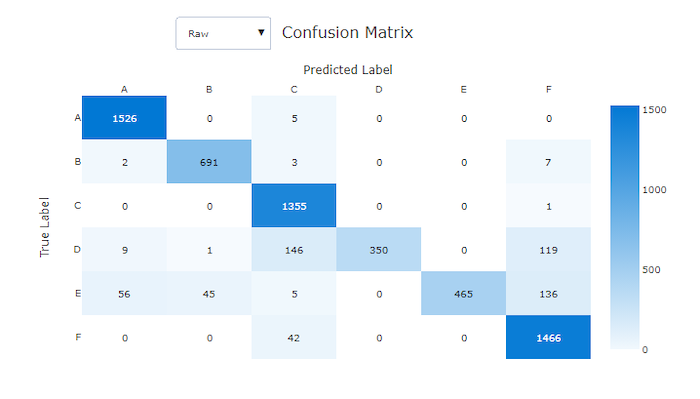
它显示的内容。 混淆矩阵按每行的实际类和每列中的预测类对样本进行计数。
如何阅读它。 在 Studio 中,颜色较深的单元格表示样本更多。 选择归一化以显示行百分比,或选择原始值以查看计数和类别不平衡情况。
注意事项。 沿对角线的浓度指示正确的分类。 非对角线上的集中情况揭示了模型经常混淆的类别对。
沿对角线集中的观察
非对角线区域混淆频繁
分类曲线
对于工作室中的每个分类曲线,请选择图例中的类标签以比较每类和平均结果。
ROC 曲线
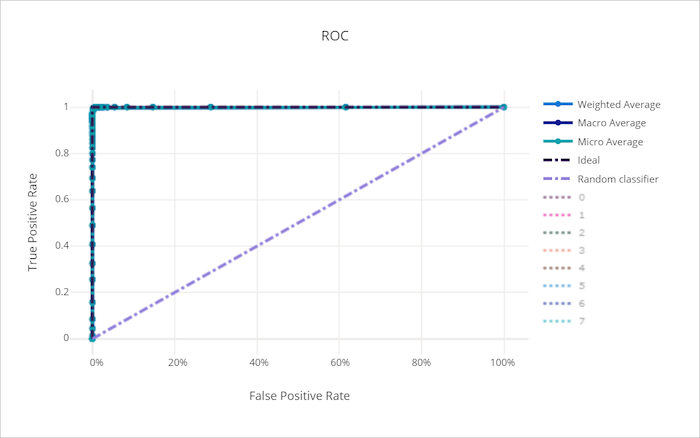
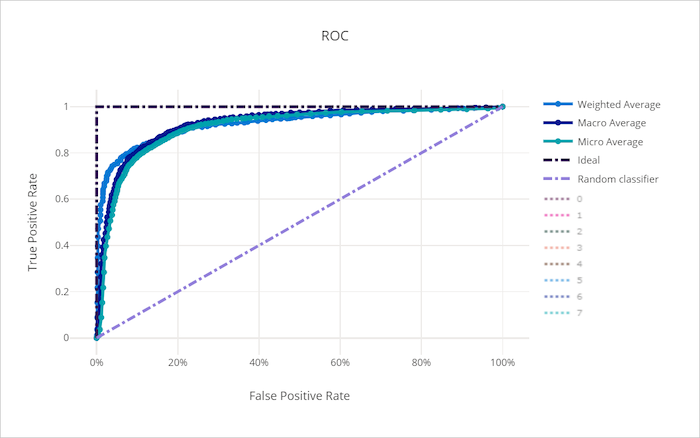
它显示的内容。 受试者工作特征(ROC)曲线表示随着决策阈值的变化,真正例率与假正例率之间的关系。
如何阅读它。 接近左上角的曲线将高真率与低误报率相结合。 曲线下的区域(ROC AUC)是分类器将随机选择的正样本排在随机选择的负样本之上的概率。 值为 1 表示排名完美,值为 0.5 表示随机排名。 有关正式定义,请参阅 scikit-learn ROC AUC 指南。
注意事项。 当类别分布高度不平衡时,ROC 可能会掩盖少数类的表现。 将其与精度召回曲线进行比较。 与准确性不同,ROC AUC 汇总了跨阈值的排名;准确性测量所选阈值的正确预测。
接近左上角的 ROC 曲线
随机模型基线附近的 ROC 曲线
精度-召回率曲线
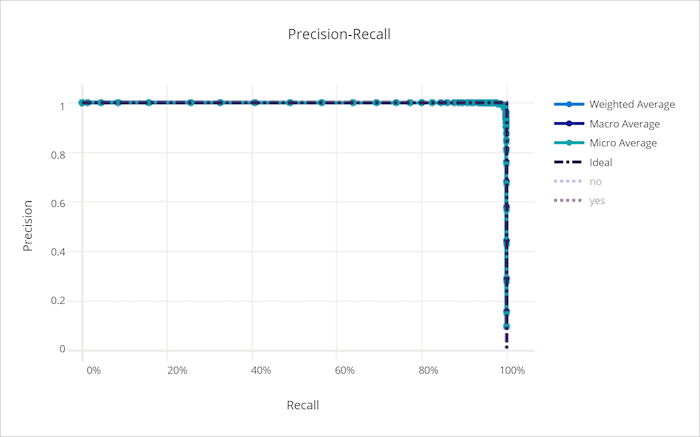
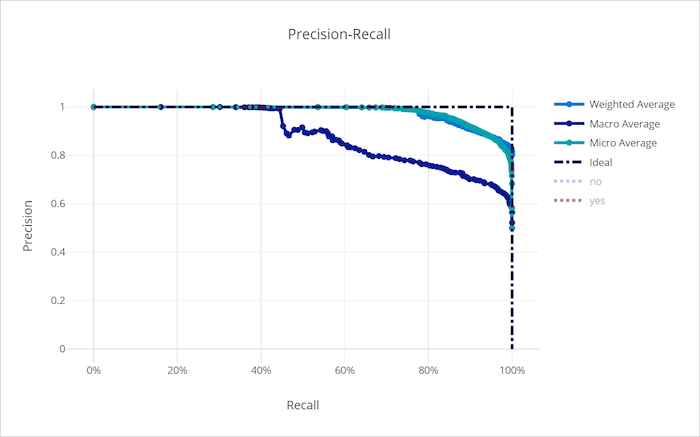
它显示的内容。 精确率-召回率曲线随着决策阈值的变化,以召回率为横轴、精确率为纵轴绘制。
如何阅读它。 随着召回率的提高,越靠近右上角的曲线仍能保持较高的精确率。 根据误报和漏报的相对成本选择曲线上的点。
注意事项。 类别占比会影响基线表现,因此应比较在同一总体上评估的模型。 当正样本不常见时,精度召回曲线通常比 ROC 曲线更有信息性。 请参阅 scikit-learn precision-recall 指南。
精度和召回率仍然很高
随着召回率的增加,精度下降
累积增益曲线
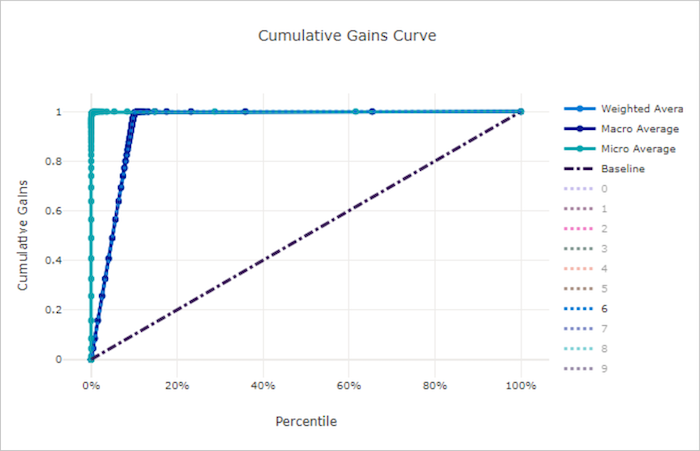
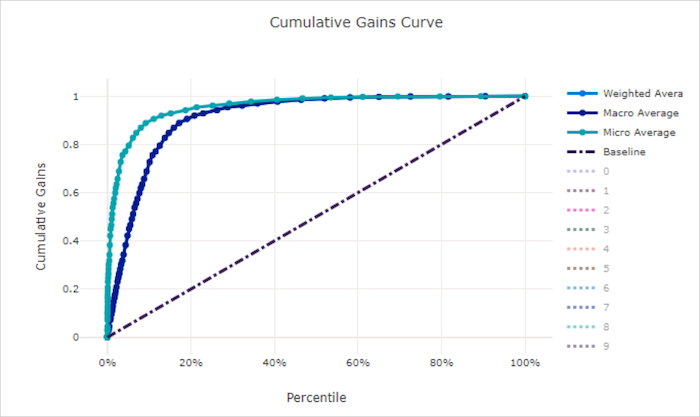
它显示的内容。 累积增益曲线按预测概率对样本进行排序,并绘制已发现的正样本占比与已检查总体占比之间的关系曲线。
如何阅读它。 在选定的总体占比下,该曲线表示捕获到的所有正样本占全部正样本的比例。 随机模型沿着对角线 y = x;有用的模型则升至该线之上。
注意事项。 在人群占比与您的容量相匹配的位置比较各条曲线。 某一占比下的较高增益,并不能证明其概率校准成立,或其在不同工作点下的性能同样良好。
累积增益迅速上升
累积增益保持在随机基线附近
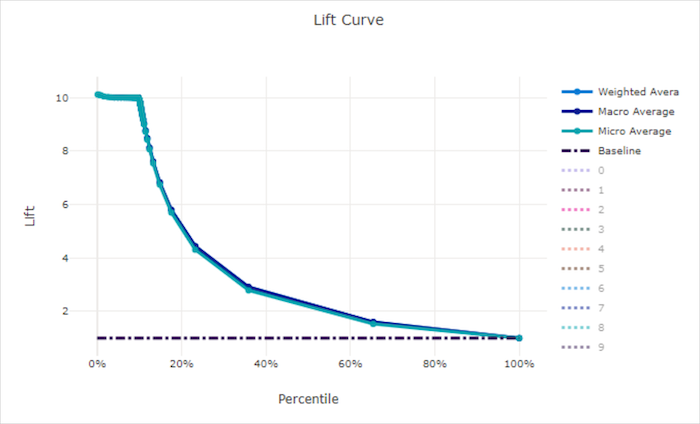
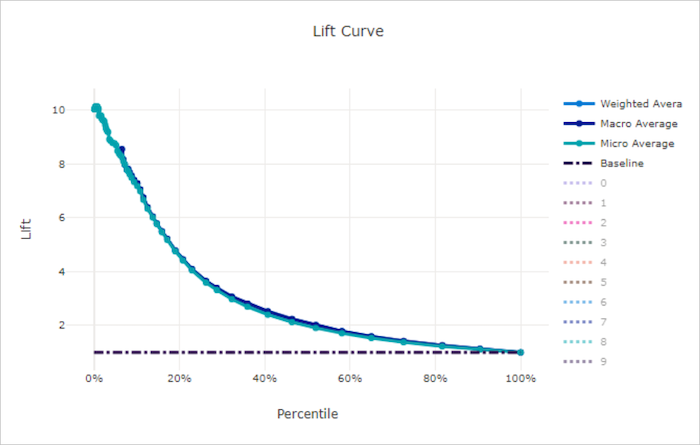
提升曲线
它显示的内容。 在每个采样人口占比下,提升度等于模型的累积增益除以随机模型在相同比例下的累积增益。
如何阅读它。 随机模型提升基线是水平线 y = 1。 提升度为 2 意味着,所选占比中的正样本占比是随机选择时期望值的两倍。
注意事项。 随着纳入总体的比例增加,提升度通常会下降。 比较应用程序可对其执行操作的分数的模型。
提升度仍高于随机基线
提升度接近随机基线
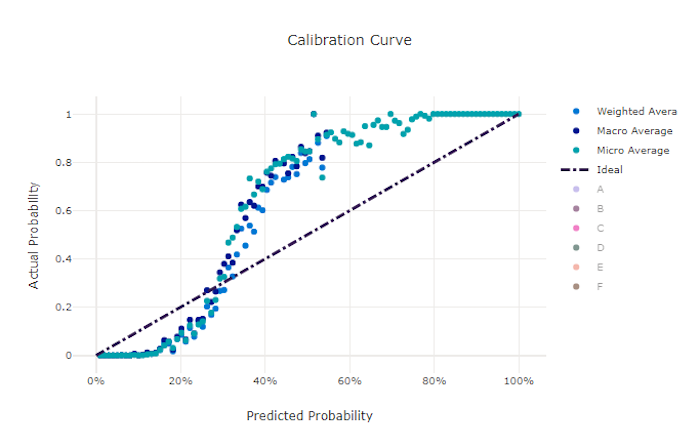
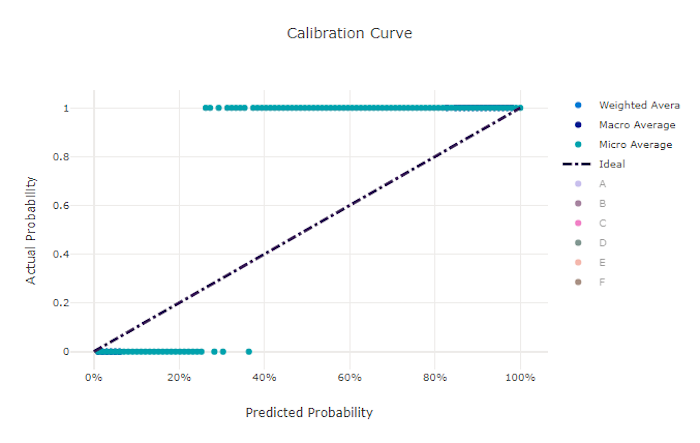
校准曲线
它显示的内容。 校准曲线将预测概率与观察到的正类频率进行比较。
如何阅读它。 校准的模型遵循对角线 y = x。 例如,在接近 0.7的预测中,大约 70% 应该是正的。
注意事项。 校准不测量分类准确性或排名。 较小的验证集也可能产生噪声较大的曲线。 请参阅 scikit-learn 校准指南。
预测概率与观察到的频率保持一致
预测概率偏离观察到的频率
评估回归和预测结果
选择回归和预测指标
如果您需要以目标变量单位表示的误差,并希望对较大误差不那么敏感,请使用 MAE 或绝对误差中位数。 如果大型错误应具有更大的影响,请使用 RMSE。 仅当实际值始终明显远离零时,才使用 MAPE;仅当实际值和预测值均为非负值时,才使用 RMSLE。
回归与预测指标参考
AutoML 报告以下回归和预测指标。
| 度量 | 它度量的内容 | 何时使用它 | 更好的价值 | Reference |
|---|---|---|---|---|
explained_variance |
预测所考虑的目标方差的比例。 | 比较各模型能解释多少变异。 | 离1更近。 |
scikit-learn explained_variance_score 参考手册 |
mean_absolute_error, normalized_mean_absolute_error |
实际值和预测值之间的平均绝对差。 | 使用以目标单位表示的误差,与 RMSE 相比,它对较大误差的敏感度更低。 | 离0更近。 |
scikit-learn mean_absolute_error 参考手册 |
mean_absolute_percentage_error |
相对于每个实际值的平均绝对误差。 | 仅当实际值保持远离零时,才比较相对误差。 | 离0更近。 |
scikit-learn mean_absolute_percentage_error 参考手册 |
median_absolute_error, normalized_median_absolute_error |
实际值和预测值之间的中间绝对差值。 | 使用可靠离群值度量值。 | 离0更近。 |
scikit-learn median_absolute_error 参考手册 |
r2_score |
相对于预测目标均值时的平方误差的按比例减少量。 | 将拟合效果与平均预测基线进行比较。 | 更接近 1;值可以是负值。 |
scikit-learn r2_score 参考手册 |
root_mean_squared_error, normalized_root_mean_squared_error |
平均平方预测误差的平方根。 | 使较大的误差比 MAE 产生更大的影响。 | 离0更近。 |
scikit-learn 根均平方错误参考 |
root_mean_squared_log_error, normalized_root_mean_squared_log_error |
应用 log(1 + value)后均方差的平方根。 |
比较非负值的尺度相对误差。 | 离0更近。 |
scikit-learn mean_squared_log_error 参考手册 |
spearman_correlation |
对实际值和预测值之间的相关性进行排名。 | 评估预测是否保留单调排序。 | 更接近 1;取值范围为 1 到 -1。 |
SciPy spearmanr 参考手册 |
MAPE 为 mean(abs((y_true - y_pred) / y_true)). 某些实现将结果显示为分数,而另一些实现则将其乘以 100 以显示百分比。
当实际值为零时,MAPE 未定义,接近零的实际值可能会产生非常大的结果。 对于这些目标系列,请改用 MAE 或 RMSE。 有关具体实现行为,请参阅 scikit-learn MAPE 参考文档。
RMSLE 为 sqrt(mean((log(1 + y_true) - log(1 + y_pred))^2)). 实际值和预测值必须是非负值。 RMSLE 衡量相对差异,并且相比等量的高估,对低估的惩罚更大。 如果可能出现负值,请使用 RMSE 或 MAE。 请参阅scikit-learn 均方对数误差参考文档。
指标规范化
AutoML 报告多个错误指标的规范化版本,以使结果在具有不同缩放的目标之间更具可比性。 由于规范化取决于评估数据,因此不要比较不同数据集中的规范化值,而无需确认它们使用一致的基础。 当你需要以目标值的原始单位表示误差时,请使用非归一化指标。
预测汇总
通过多个时序预测评估可以采用两种方式聚合结果:
- 在计算其指标后,宏平均值为每个序列提供相等的影响。
- 微平均值 使每个预测在所有序列中都产生同等的影响。
高流量序列可能会主导微观指标。 当每个系列具有类似的业务重要性时,宏规范化指标通常更有用,但在选择模型之前检查聚合结果和每系列结果。
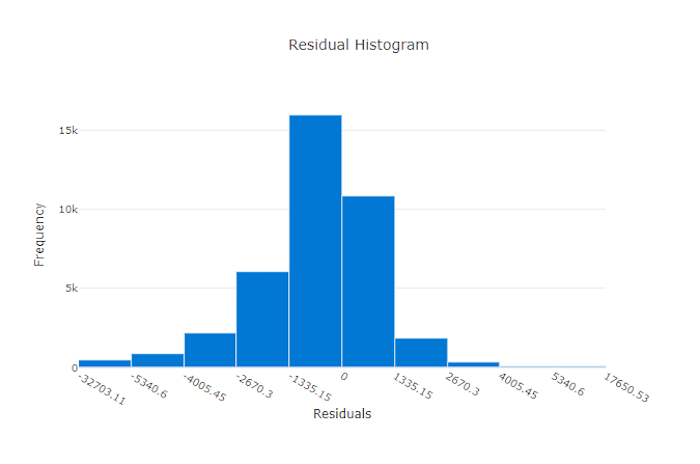
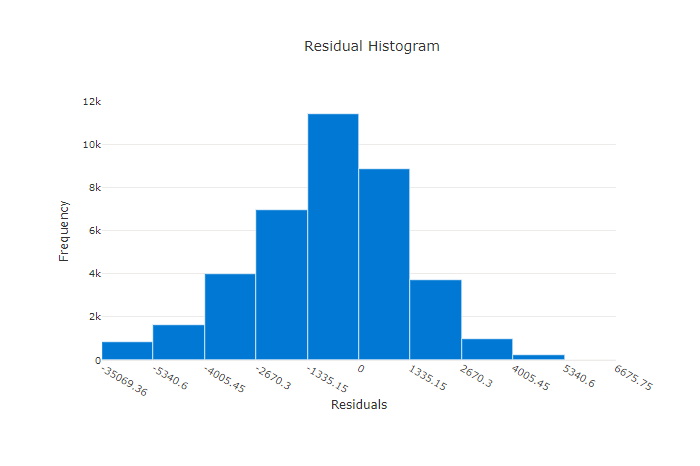
残差
它显示的内容。 残差图表显示回归和预测模型的预测误差分布。
如何阅读它。 分布集中在零附近,几乎没有极端错误表示预测通常接近实际值。
注意事项。 偏离零的分布表明存在偏差。 较宽或不对称的尾部可能会揭示被聚合指标掩盖的较大误差或异常行为。
残余误差集中在零附近
残余误差广泛分布
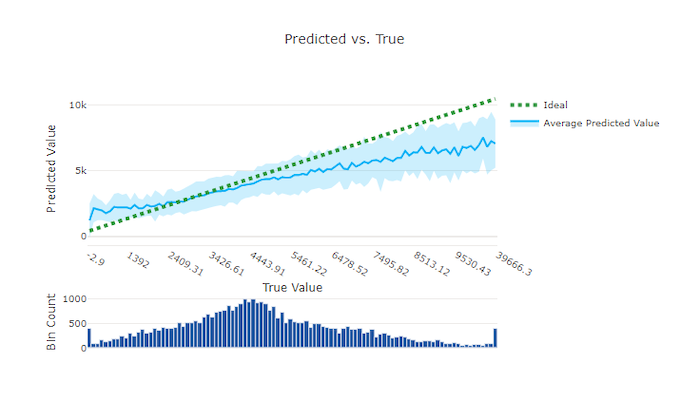
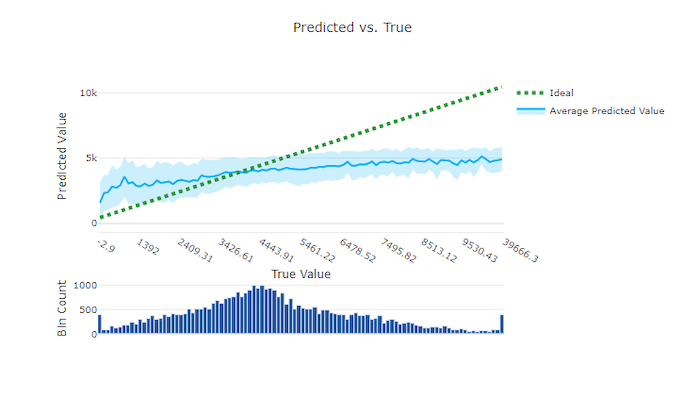
预测值与实际值
它显示的内容。 该图表将水平轴上的实际目标值进行分箱,并绘制每个分箱的平均预测值及其变化情况。
如何阅读它。 接近理想对角线 y = x 的预测与实际值保持一致。 使用随附的直方图查看每个区域支持的数据量。
注意事项。 与对角线的较大偏离表明存在系统性的预测偏低或预测偏高。 稀疏区域可能会产生不太稳定的估计。
接近理想对角线的预测
预测偏离理想对角线
预测时域
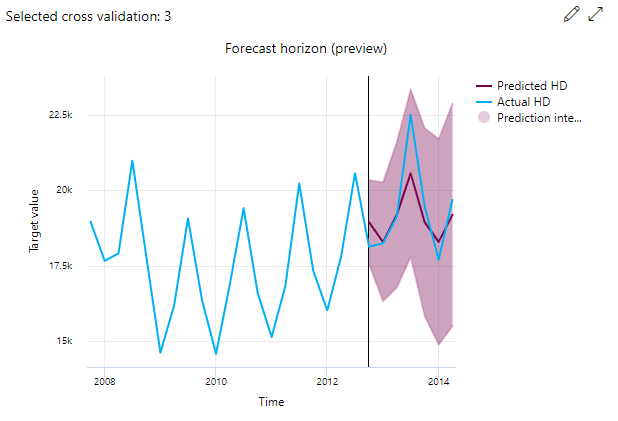
它显示的内容。 对于预测任务,预测范围图会针对交叉验证折和时间序列,对比随时间变化的预测值与实际值。 预测原点是预测开始的时间点。
如何阅读它。 在地平线左侧,使用历史值来了解前面的趋势。 右侧,将预测与实际值进行比较,并检查预测间隔。
注意事项。 在图表中选择不同的折叠和系列,以查找聚合指标隐藏的错误。 检查是否存在漂移、对变化响应延迟以及不包含实际值的区间。
评估图像模型结果
图像分类
对于多类图像分类,主要指标是准确性。 对于多标签图像分类,主要评价指标是交并比(IoU)。
多标签分类应用置信度阈值来确定每个标签是否存在。 多类分类改为选择具有最高置信度分数的类。
对象检测和实例分段
对象检测和实例分段使用 IoU 测量预测区域与其地基区域之间的重叠。 平均平均精度 (mAP) 汇总了各类的平均精度。
使推理筛选与验证匹配分开:
| 设置 | Purpose |
|---|---|
box_score_threshold |
对推理输出进行筛选。 在预测时,AutoML 仅返回分类置信度大于此阈值的框。 它未配置验证指标。 |
validation_metric_type |
选择验证指标约定,例如 coco 或 voc。 |
validation_iou_threshold |
设置在计算验证指标时用于匹配预测框和真实框的 IoU 阈值。 |
有关接受的值和默认值,请参阅 对象检测和实例分段超参数。 有关 COCO 规范,请参阅 官方 COCO 检测评估参考资料。 有关 Pascal VOC,请参阅官方 Pascal VOC 评估文档。
使用负责任的 AI 见解
默认情况下不会生成集成的 AutoML 负责任的 AI 仪表板。 它可以为最佳推荐模型提供模型性能、公平性、数据浏览、解释和错误分析见解。
重要
集成工作流需要:
- 受支持的新 AutoML 分类或回归作业。
- 在配置作业时启用 “解释最佳模型” 选项。
- 适合任务需求的算力。
- 该作业生成的最优推荐模型。
集成工作流不会追溯地为现有 AutoML 模型创建仪表板。 若要配置并打开它,请参阅 在工作室中创建 AutoML 负责任的 AI 仪表板。
通用负责任的 AI SDK 和 CLI 工作流独立于集成的 AutoML 体验。 当你需要为任意受支持的模型创建仪表板时,构建该流水线。 有关支持的输入和组件,请参阅使用 YAML 和Python生成负责任的 AI 见解。