高效放置和优化 GPU 工作负荷通常需要了解资源利用率和性能。 AKS 上的托管 GPU 指标提供跨已启用 NVIDIA GPU 的节点池的 GPU 利用率、内存和性能数据的自动收集和公开。 此功能使平台管理员能够优化群集资源,并使开发人员能够通过有限的手动插桩来优化和调试工作负荷。
在本文中,你将了解 NVIDIA 数据中心 GPU 管理器 (DCGM)导出器在 Azure Kubernetes 服务 (AKS) 中通过托管的 GPU 支持节点池收集的 GPU 指标。
先决条件
- 一个具有 启用了托管 GPU 的节点池 的 AKS 群集,并确保 GPU 可调度。
- 将 示例 GPU 工作负载 部署到节点池中。
- Azure 托管 Prometheus已在 AKS 群集上启用。
验证是否已安装托管 GPU 组件
按照 以下说明创建托管 NVIDIA GPU 节点池后,请使用 az aks nodepool show 命令确认已安装 GPU 软件组件:
az aks nodepool show \
    --resource-group <resource-group-name> \
    --cluster-name <cluster-name> \
    --name <node-pool-name> \
输出应包含以下值:
  ...
  "gpuProfile": {
      "driver": "Install",
      "driverType": "",
      "nvidia": {
          "managementMode": "Managed",
          ...
          ...
      }
  },
...
...
在 Azure 托管 Prometheus 中自定义抓取 GPU 指标
创建并应用 ConfigMap,以便在 dcgm-exporter 命名空间中的 Azure Monitor 代理中,从 kube-system 为 NVIDIA GPU 指标启用提取配置文件,如下所示:
cat <<EOF | kubectl create -f -
kind: ConfigMap
apiVersion: v1
data:
  schema-version:
    v1
  config-version:
    ver1
  default-scrape-settings-enabled: |-
    dcgmexporter = true
metadata:
  name: ama-metrics-settings-configmap
  namespace: kube-system
EOF
注释
在 AKS 群集上应用此 ConfigMap 后,会自动擦除添加到群集的所有现有和新 NVIDIA GPU 节点池。
在 Azure 托管 Prometheus 中禁用 GPU 指标的自动抓取
若要禁用 Azure Monitor 托管的 Prometheus (AMA) 代理对 NVIDIA DCGM 指标的抓取,请编辑相同的 ConfigMap。 GPU 工作负载不会受到影响。
运行下面的命令:
kubectl edit configmap ama-metrics-settings-configmap -n kube-system
将dcgmexporter设置从true更新为false:
...
...
default-scrape-settings-enabled: |-
  dcgmexporter = false
...
...
NVIDIA DCGM 指标不再显示在Azure Monitor或指标资源管理器中。
在 Azure 门户中监视 GPU 指标
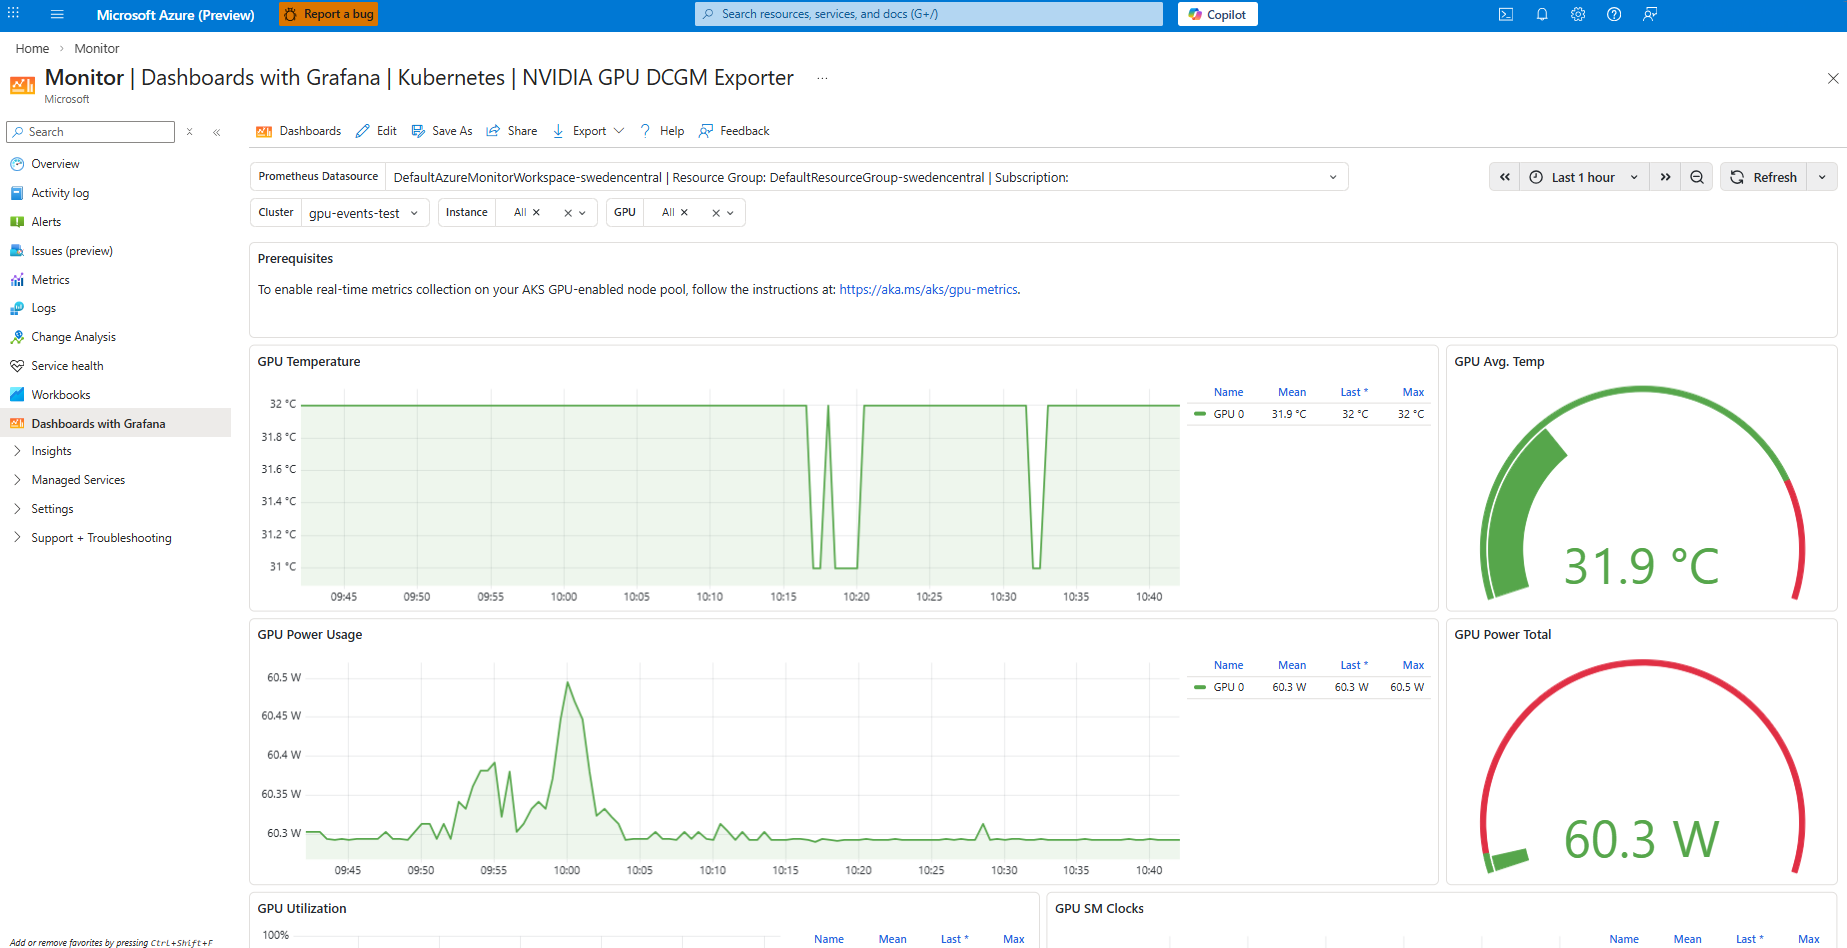
为 AKS 群集创建 Azure Monitor 工作区后,转到 Azure 门户并在 Azure Monitor 工作区中打开 Azure Monitor>Dashboards with Grafana。
使用搜索栏,筛选带有
Kubernetes | NVIDIA GPU DCGM Exporter标签的Azure-managedGrafana 仪表板。选择此仪表板,并确认所选
Cluster与已启用 GPU 的Prometheus Datasource节点池匹配。 现在可以查看实时 GPU 指标,如下图所示:
了解 GPU 指标
GPU 利用率指标
GPU 使用率指标显示 GPU 核心正在主动处理工作的百分比。 高值表示 GPU 被大量使用,这通常适用于训练或数据处理等工作负荷。 此指标的解释应考虑工作负荷的类型:AI 训练通常保持高利用率,而推理可能因流量突发而出现间歇性利用率。
内存利用率:显示正在使用的 GPU 内存百分比。 内存使用率高,而 GPU 使用率不高,可能表明是受内存限制的工作负载,导致 GPU 等待内存传输。 低利用率的内存使用率可能表明工作负荷太小,无法完全利用 GPU。
SM(流式处理多处理器)效率:测量 GPU 核心使用的效率。 低 SM 效率表示,由于工作负荷不平衡或未充分利用内核设计,内核处于空闲或未充分利用状态。 高效率非常适合计算密集型应用程序。
内存指标
内存带宽利用率:反映消耗的理论内存带宽量。 高带宽利用率和低计算利用率可能表示内存受限的工作负载。 相反,计算和内存带宽中的高利用率都表明工作负荷平衡良好。
内存错误:如果启用,跟踪错误更正代码(ECC)错误。 大量错误可能表示硬件降级或热问题,应监视其可靠性。
温度和电源指标
GPU 温度:指示 GPU 的运行温度。 持续的高温会触发热降频,降低性能。 此指标的理想解释涉及观察相对于 GPU 的热限制和冷却容量的温度。
功率使用情况:显示即时功率消耗。 将电源使用情况与 TDP(热设计电源)进行比较有助于了解 GPU 是否被推送到其限制。 电力突然降低可能表示性能限频或资源未充分利用。
时钟和频率指标
GPU 时钟:GPU 的实际作频率。 结合利用率,这有助于确定 GPU 是否因限制而降低性能或未能发挥其潜力。
内存时钟:GPU 内存的运行频率。 内存绑定的工作负载可能会受益于更高的内存频率,内存与计算利用率不匹配可能会突出显示瓶颈。
PCIe 和 NVLink 指标
PCIe 带宽:通过 PCIe 总线测量吞吐量。 工作负荷使用率低可能表明 CPU-GPU 通信不是瓶颈。 高利用率可能指向影响性能的数据传输限制。
NVLink 带宽:此指标类似于 PCIe 带宽,但特定于 NVLink 互连,在多 GPU 系统中与跨 GPU 通信相关。 具有低 SM 利用率的高 NVLink 使用率可能表示同步或数据传输延迟。
错误和可靠性指标
已停用的页面和 XID 错误:监测 GPU 的内存错误和关键故障。 对于长时间运行的工作负荷,频繁出现的情况可能是潜在的硬件故障信号,需要加以关注。
解释指南
DCGM 指标应根据 AKS 上的工作负荷类型进行上下文解释。 理想情况下,高计算密集型工作负荷应显示高 GPU 和 SM 利用率、高内存带宽使用率、温度稳定在低于限制阈值的范围内,以及电源消耗接近但低于 TDP。
内存绑定工作负荷可能会显示较高的内存利用率和带宽,但计算利用率较低。 出现高温或高能耗但利用率低等异常情况通常表明存在降频、任务调度效率低或系统级瓶颈。
监视一段时间内的趋势,而不是单个快照至关重要。 在影响生产工作负荷之前,利用率突然下降或错误峰值通常会揭示根本问题。 比较多个 GPU 之间的指标还有助于识别节点池中的离群值或表现异常的设备。 通过组合了解这些指标,而不是隔离,可以清楚地了解 GPU 效率和工作负荷性能。
常见 GPU 指标
以下 NVIDIA DCGM 指标通常针对 Kubernetes 上的 GPU 节点池的性能进行评估:
| GPU 指标名称 | Meaning | 典型范围/指示器 | 使用提示 |
|---|---|---|---|
DCGM_FI_DEV_GPU_UTIL |
GPU 利用率(% GPU 核心处于活动状态的时间) | 0–100% (更高更好) | 监视每个节点和每个 Pod;低值可能表示 CPU 或 I/O 瓶颈 |
DCGM_FI_DEV_SM_UTIL |
流式处理多处理器效率(% 活动核心) | 0–100% | 较高内存使用下的低值表示内存受限的工作负荷 |
DCGM_FI_DEV_FB_USED |
使用的帧缓冲区内存(字节) | 0 到总内存 | 使用 Pod GPU 内存限制并跟踪每个 Pod 内存使用情况 |
DCGM_FI_DEV_FB_FREE |
空闲 GPU 内存(字节) | 0 到总内存 | 可用于计划调度和避免 OOM 错误 |
DCGM_FI_DEV_MEMORY_UTIL |
内存使用率 (%) | 0–100% | 结合 GPU/SM 利用率来确定内存绑定工作负荷 |
DCGM_FI_DEV_MEMORY_CLOCK |
当前内存时钟频率 (MHz) | 从 0 到最大内存时钟 | 内存使用率高时的低值可能表示降频 |
DCGM_FI_DEV_POWER_USAGE |
即时电源使用(瓦茨) | 0 到 TDP | 高使用率期间的下降可能表示限流 |
DCGM_FI_DEV_TEMPERATURE |
GPU 温度 (°C) | 约 30–85°C 正常 | 针对持续高温的警报 |
DCGM_FI_DEV_NVLINK_RX |
NVLink 接收带宽利用率(%) | 0–100% | 如果 GPU 利用率高而 SM 利用率低,则出现多 GPU 同步瓶颈 |
DCGM_FI_DEV_XID_ERRORS |
驱动程序报告的 GPU 严重错误 | 通常为 0 | 需要立即进行调查;可以在 Kubernetes 中给节点打污点 |
若要了解完整的 GPU 指标套件,请访问 NVIDIA DCGM 上游文档。
后续步骤
- 了解 AKS 上的 GPU 可观测性最佳做法
- 使用节点问题检测器跟踪 GPU 节点运行状况 (NPD)
- 在 AKS 群集上创建 多实例 GPU 节点池