小窍门
要使用 Claude Code、Codex 或 OpenCode 配置追踪,请在应用程序的代码仓库中运行 MLflow 设置向导:
curl -LsSf https://mlflow.org/wizard/setup.sh | sh
智能体可观测性与质量,是指从第一次追踪到生产环境,对你的 AI 智能体进行衡量、调试和改进的实践。 在Databricks上,你用 MLflow来实现这一点。 Databricks 上的 MLflow 本身就是 MLflow——同一个开源产品,只是由 Databricks 平台托管并与之集成,因此你的追踪、评估和提示词会与其余数据一同存放在 Unity Catalog 中。
从追踪开始
代理追踪会完整记录每一次代理执行。 一条跟踪包括初始输入和最终输出,以及每个中间步骤——如模型调用、工具调用和检索——以及每一步的输入、输出、延迟、令牌使用和成本。
追踪是代理可观察性和质量的基础。 它让你分析人们如何使用你的经纪人,以及它花时间和金钱在哪里。 更重要的是,它为你提供了提升经纪人所需的证据。 只有输入和最终响应,你无法判断哪个中间决策导致了失败。 有了追踪,你可以检查每一步,诊断问题,收集上下文反馈,并将代表性的失败转化为评估和黄金数据集。
你可以使用追踪来:
分析代理使用情况、延迟、令牌消耗和成本。
排查模型调用、检索和工具使用过程中的故障。
在执行审查的背景下收集人力反馈。
从代表性的生产失败中构建评估和黄金数据集。
进行评估并监控生产质量。
质量循环
改进一个智能体不是一次性的步骤,而是一个需要持续运行的循环。 每一轮都会修复一个问题,并暴露出下一个问题。
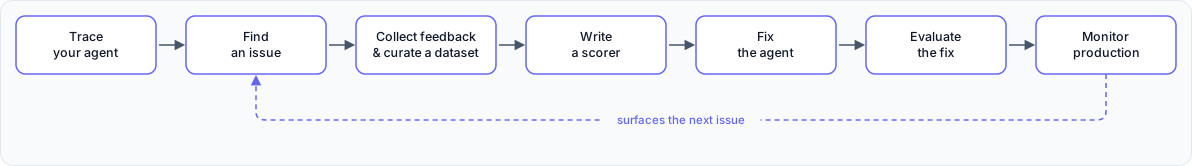
追踪你的经纪人。 给你的代理安装仪器,确保每次执行都被记录为痕迹——后续步骤的证据依赖于此。
找出问题。 发现开发跟踪中的失败,或发现生产中的退步。
收集反馈并策划数据集。 与开发人员、领域专家或用户一起审查失败的跟踪记录。 记录跟踪反馈,使其与被审查的执行保持连接,然后将代表性的失败和已知良好的示例转化为评估或黄金数据集。
编写一个评分器。 定义一个评分器(LLM裁判或基于代码的检查),自动发现问题。
修复代理。 不断迭代你的提示或代理,以解决根本原因。
评估修复方案。 重新针对你的数据集运行评估,以确认修复已生效,并且没有引入其他问题。
监控生产。 在实时流量上运行你的评分器,避免同类问题再次发生——同时暴露出下一个需要修复的问题。
旅程
如果你是新手,就从顶层开始;如果你已经知道自己在哪里,就跳到某个阶段。
| 阶段 | Description |
|---|---|
| 为你的经纪人提供工具 | 添加追踪以捕捉每一个输入、步骤和输出。 跟踪记录存储在Unity Catalog中(推荐)——受控、可SQL查询,是其他所有数据的基础。 |
| 观察并发现代理问题 | 在界面中探索痕迹,并用Genie Code用自然语言提问——无需SQL。 对追踪数据进行聚类,以识别反复出现的故障模式,并更快地发现问题。 |
| 收集反馈并构建数据集 | 收集开发者和专家反馈,将失败的痕迹转化为评估数据集。 |
| 评估并提升质量 | 使用内置和自定义评分器开展评估,然后迭代优化你的提示词和代理,以修复发现的问题。 |
| 在生产环境中监控 | 持续对实时流量进行评分,捕捉回归问题,并在用户发现之前检测出新的问题。 |
后续步骤
准备好开始这个循环了吗? 给你的经纪人安装仪器 ,捕捉你的第一批痕迹。