小窍门
可选地安装 mlflow/skills ,以便与MLflow更深入地集成。
人类判断——来自开发者、用户和领域专家的评分、评论以及基准预期——是让评估始终与“好”对你的应用究竟意味着什么保持一致的关键。 在 MLflow 中,你可以将该判断直接记录在追踪中,而带有真实值预期的追踪就会成为可直接用于自动评估的现成测试用例。
快速概览:将跟踪转换为测试用例
在 “Traces” 标签中,点击“trace”即可打开。
点击 “评估”,然后 添加期望 值以记录正确答案(实地情况)。 期望值存储在轨迹中,与输入、输出及其他反馈一同。
点击 添加到数据集 ,将追踪及其期望添加到 评估数据集中。
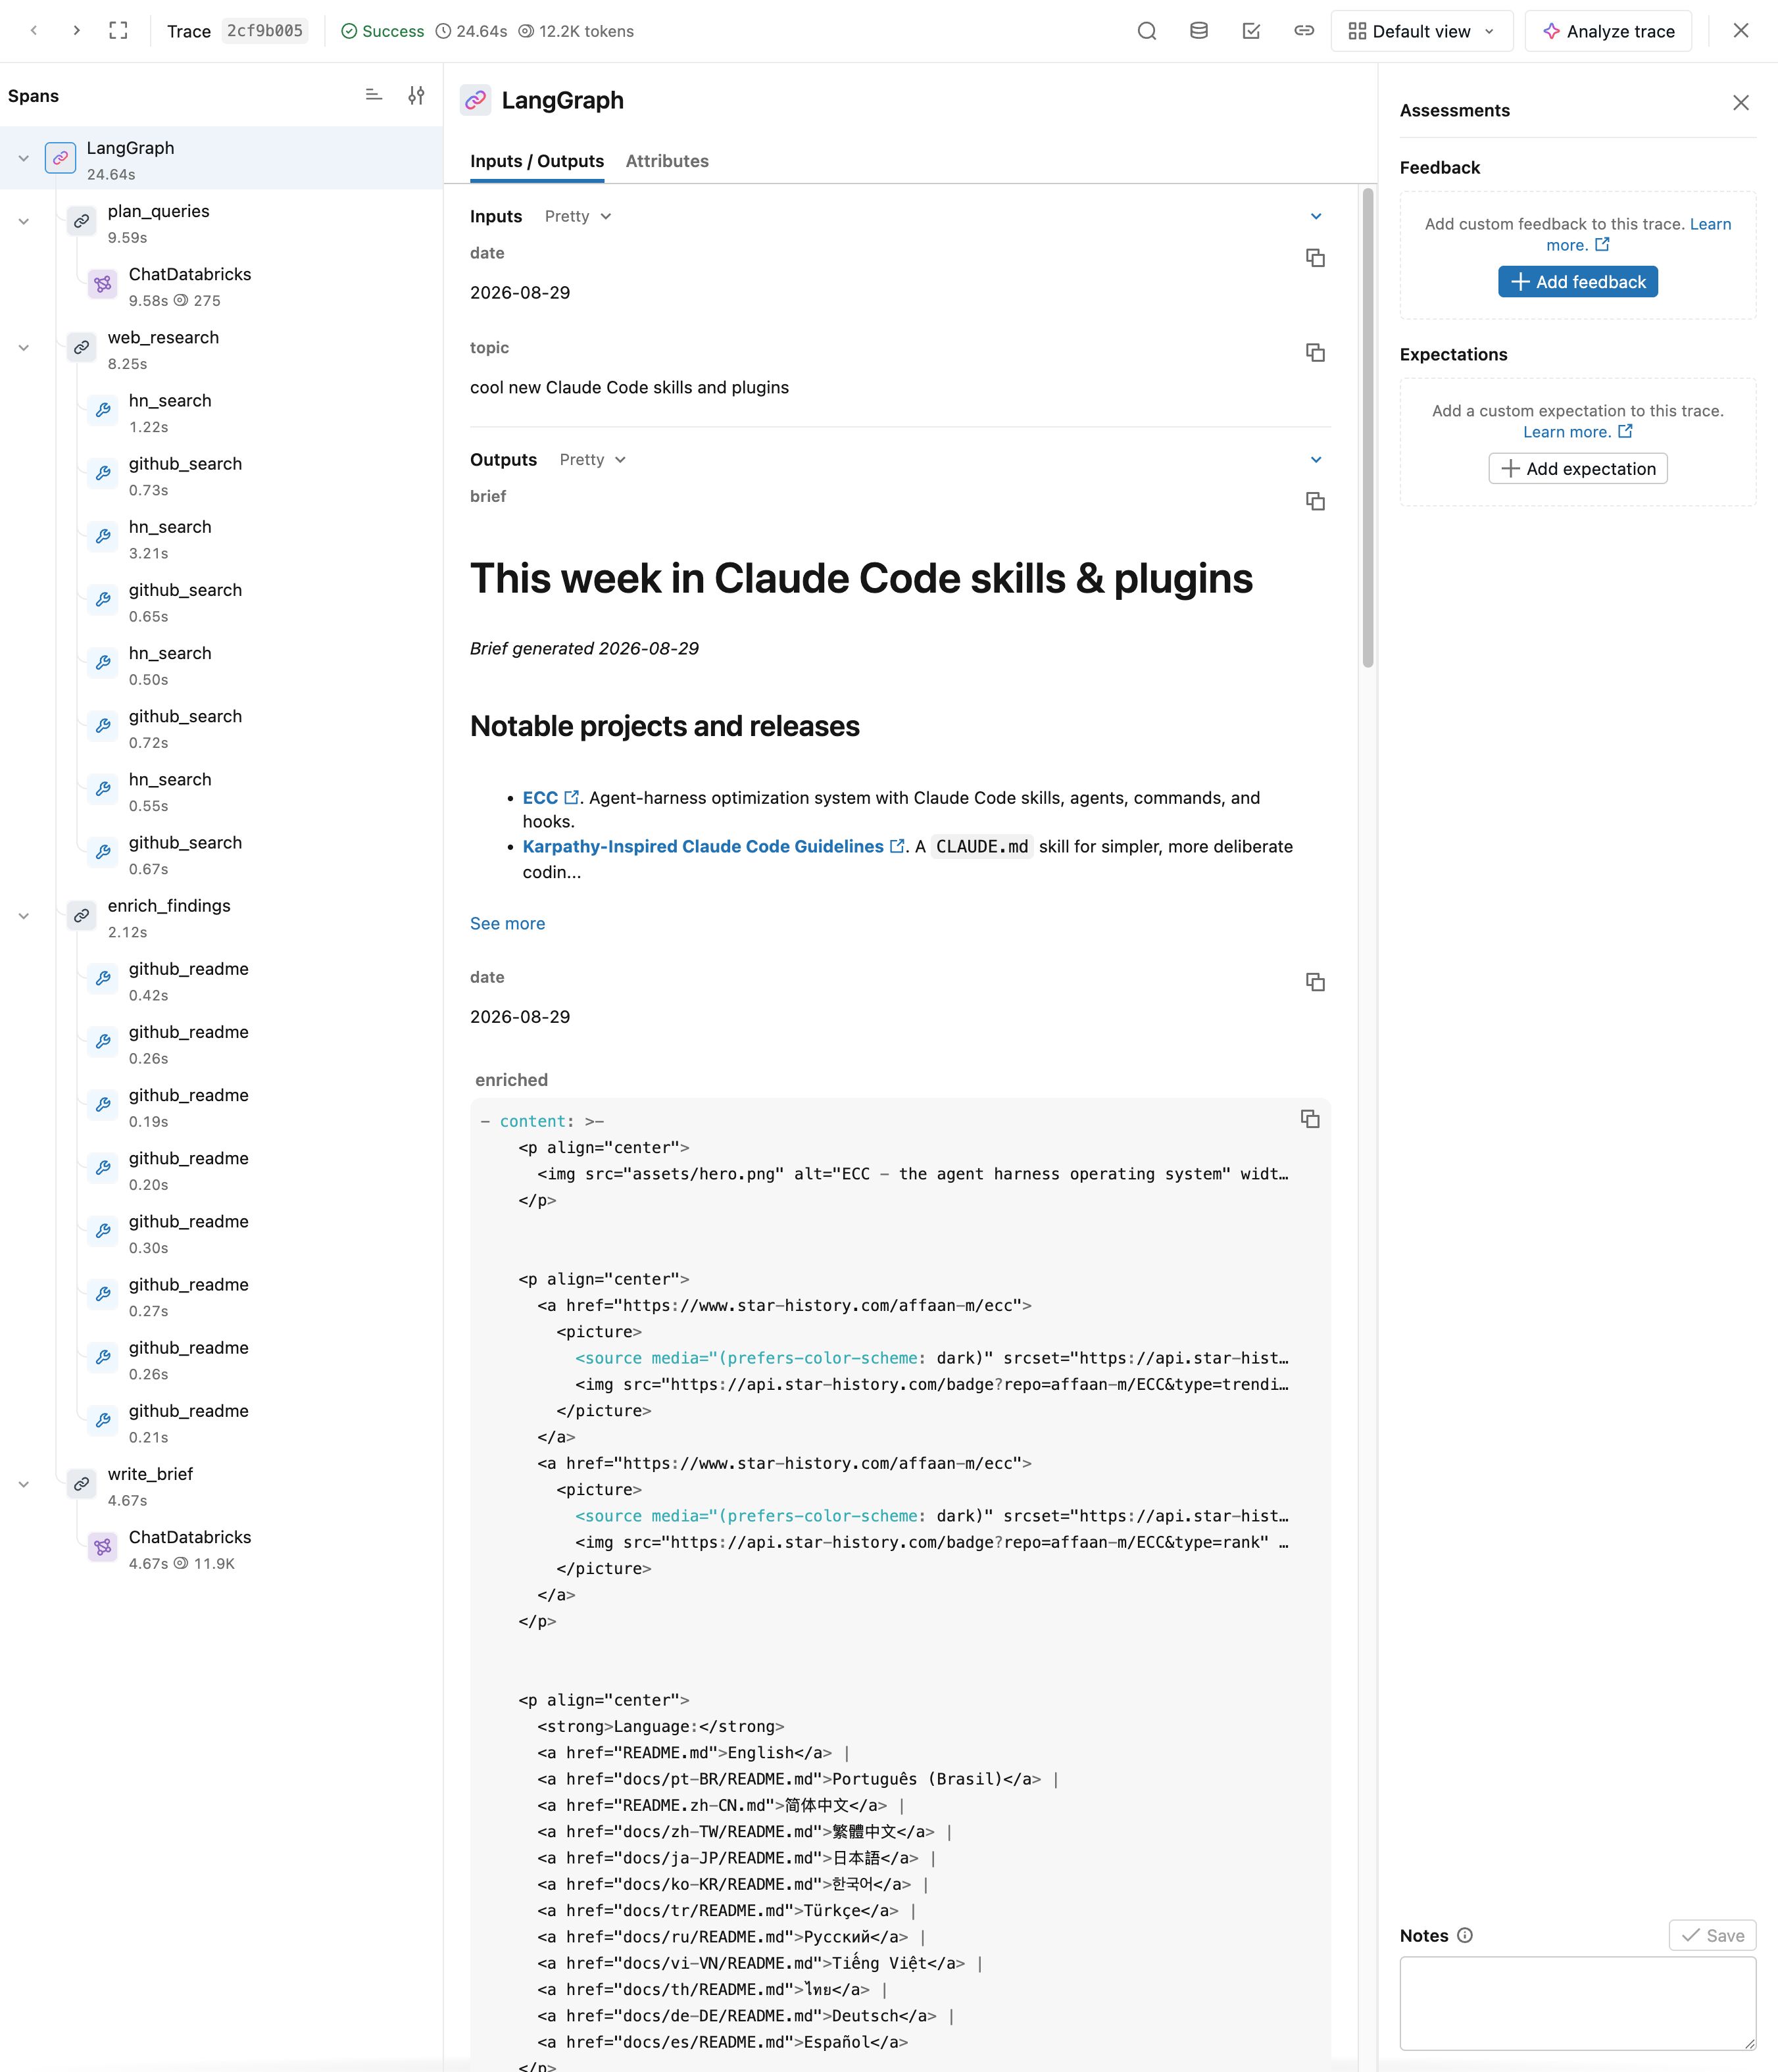
这个痕迹现在就是一个测试案例:你捕捉了真实交互中的预期答案,并将其提升到一个可用于评估未来版本的数据集。 由于反馈直接附在追踪记录上,任何查看追踪记录的人——不只是开发者——都可以无需离开追踪界面就进行此操作。
谁会留下反馈
反馈有两种形式——反馈评估应用的实际输出(反应是否良好?),期望定义正确的、真实的输出。 每种评判的来源都有自己的机制。
Developers
在构建过程中为追踪记录添加注释,以跟踪质量备注并标记用于回归测试的示例。 请参见 以开发人员身份标记追踪。
域专家
通过评审应用与主题专家互动,定义高质量的回答,并使LLM评委与您的业务需求保持一致。 有两种方式:使用聊天界面测试代理,或让专家和协作者对追踪记录进行标注。
最终用户
收集用户对已部署应用的反馈,以发现有问题的查询并保持成功互动。 请参阅 Enrich 跟踪:标记、上下文和反馈。
后续步骤
使专家和合作者能够标记痕迹 ——引入领域专家和合作者来标记痕迹。
构建MLflow评估数据集 ——将标记的痕迹和期望打包到数据集中。
评估与改进 ——根据你构建的数据集评估和改进你的应用。