当一个作业主导工作负载的大部分运行时长时,这些时间通常集中在该作业的一个或几个阶段。 找到最长的阶段,并读取其 I/O 和任务数量,可以将问题缩小到特定原因,比如溢出、数据倾斜、高 I/O 或并行性不足。
在 工作时间线 显示一个或几个长任务后,或者按时长排序并打开最长的任务后,使用此页面。 如果时间线显示不同的模式,请查看该模式的页面:
找到最长的阶段
首先确定作业的最长阶段。 请滚动到职位页面底部的各阶段列表,并按持续时间排序:

阶段 I/O 详细信息
请使用 输入、输出、Shuffle 读取和Shuffle 写入列,查看本阶段的高级 I/O 数据:
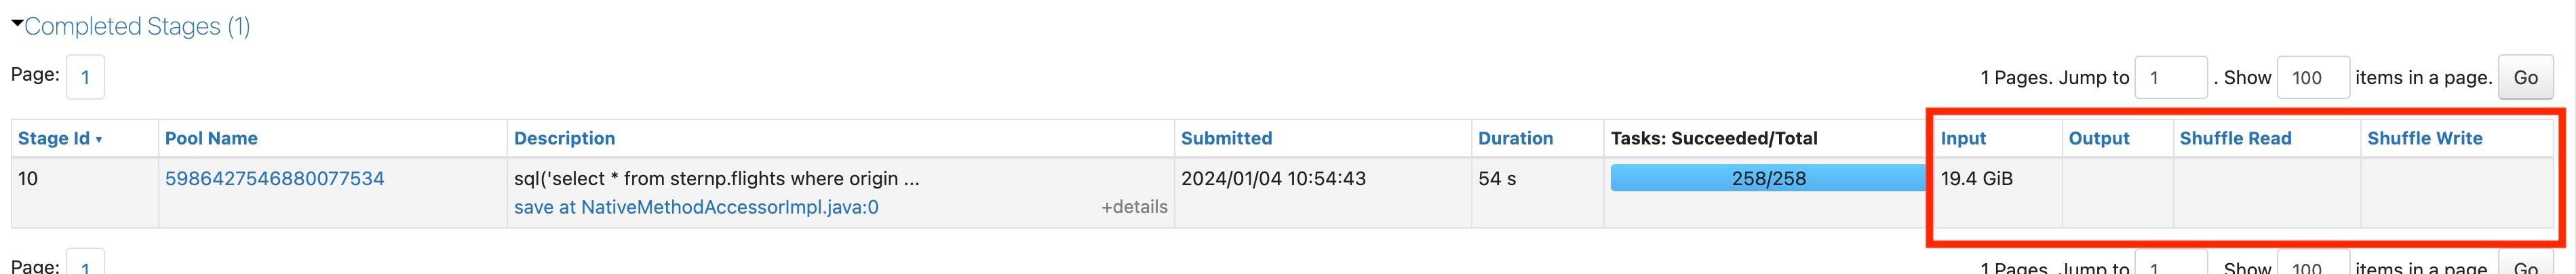
每列显示:
输入: 该阶段从存储(如Delta Lake、Parquet或CSV文件)读取多少数据。
输出: 该阶段写入到 Delta Lake、Parquet 或 CSV 文件等存储中的数据量。
随机读取: 此阶段读取的随机数据量。
随机写入: 这个阶段写了多少随机数据。
记录这些数字,供后续步骤使用。
任务数
长期阶段的任务数量有助于识别原因。 以下截图显示了在哪里找到任务数量:

单个任务意味着阶段没有并行运行,只有一个核心在做工作,集群其余部分都在等待。 如果阶段只有一个任务,请参见 只有一个任务的 Long Spark 阶段。
查看更多阶段详细信息
如果阶段有多个任务,请进一步调查。 点击赛段描述中的链接查看最长赛段的详细信息:

接下来,参见 Skew and Spill。