如果一个阶段运行缓慢,但读取、写入和重分发的数据都很少,查询本身通常是瓶颈。
在排除最长阶段中的 数据倾斜和溢写 以及 高 I/O 后,使用此页面。 如果该阶段只有一个任务,请参见 只有一个任务的 Long Spark 阶段。
一个慢且 I/O 较少的阶段可能有以下原因:
使用SQL DAG来识别几乎所有这些问题。
打开 SQL DAG
要打开 SQL DAG,请滚动到作业页面顶部并点击 关联 SQL 查询:
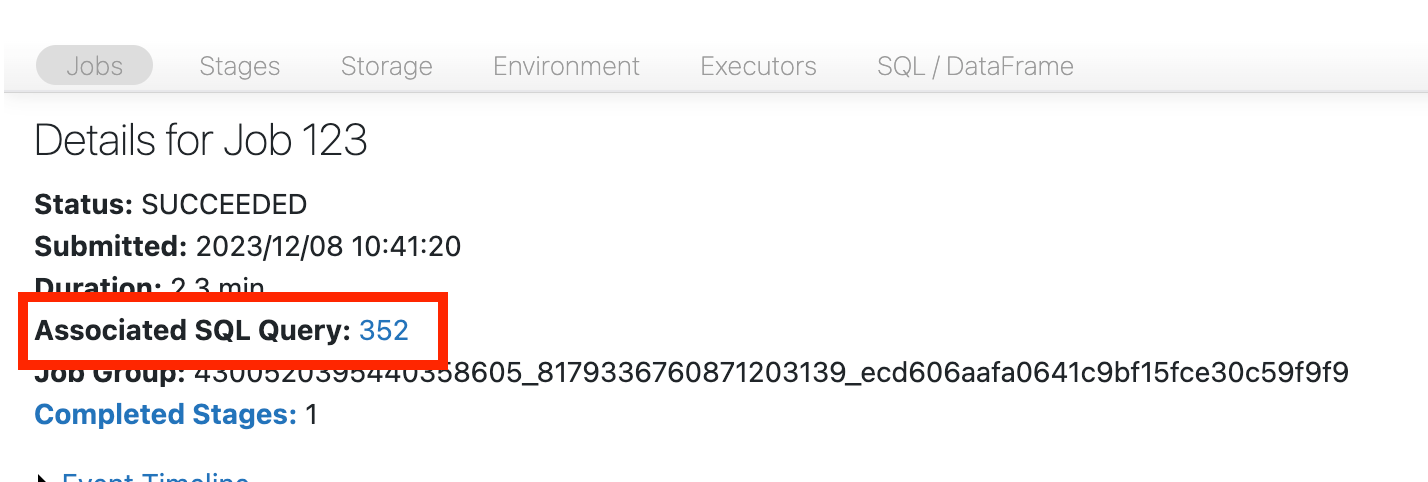
DAG出现了。 如果没有显示,请滚动查找:
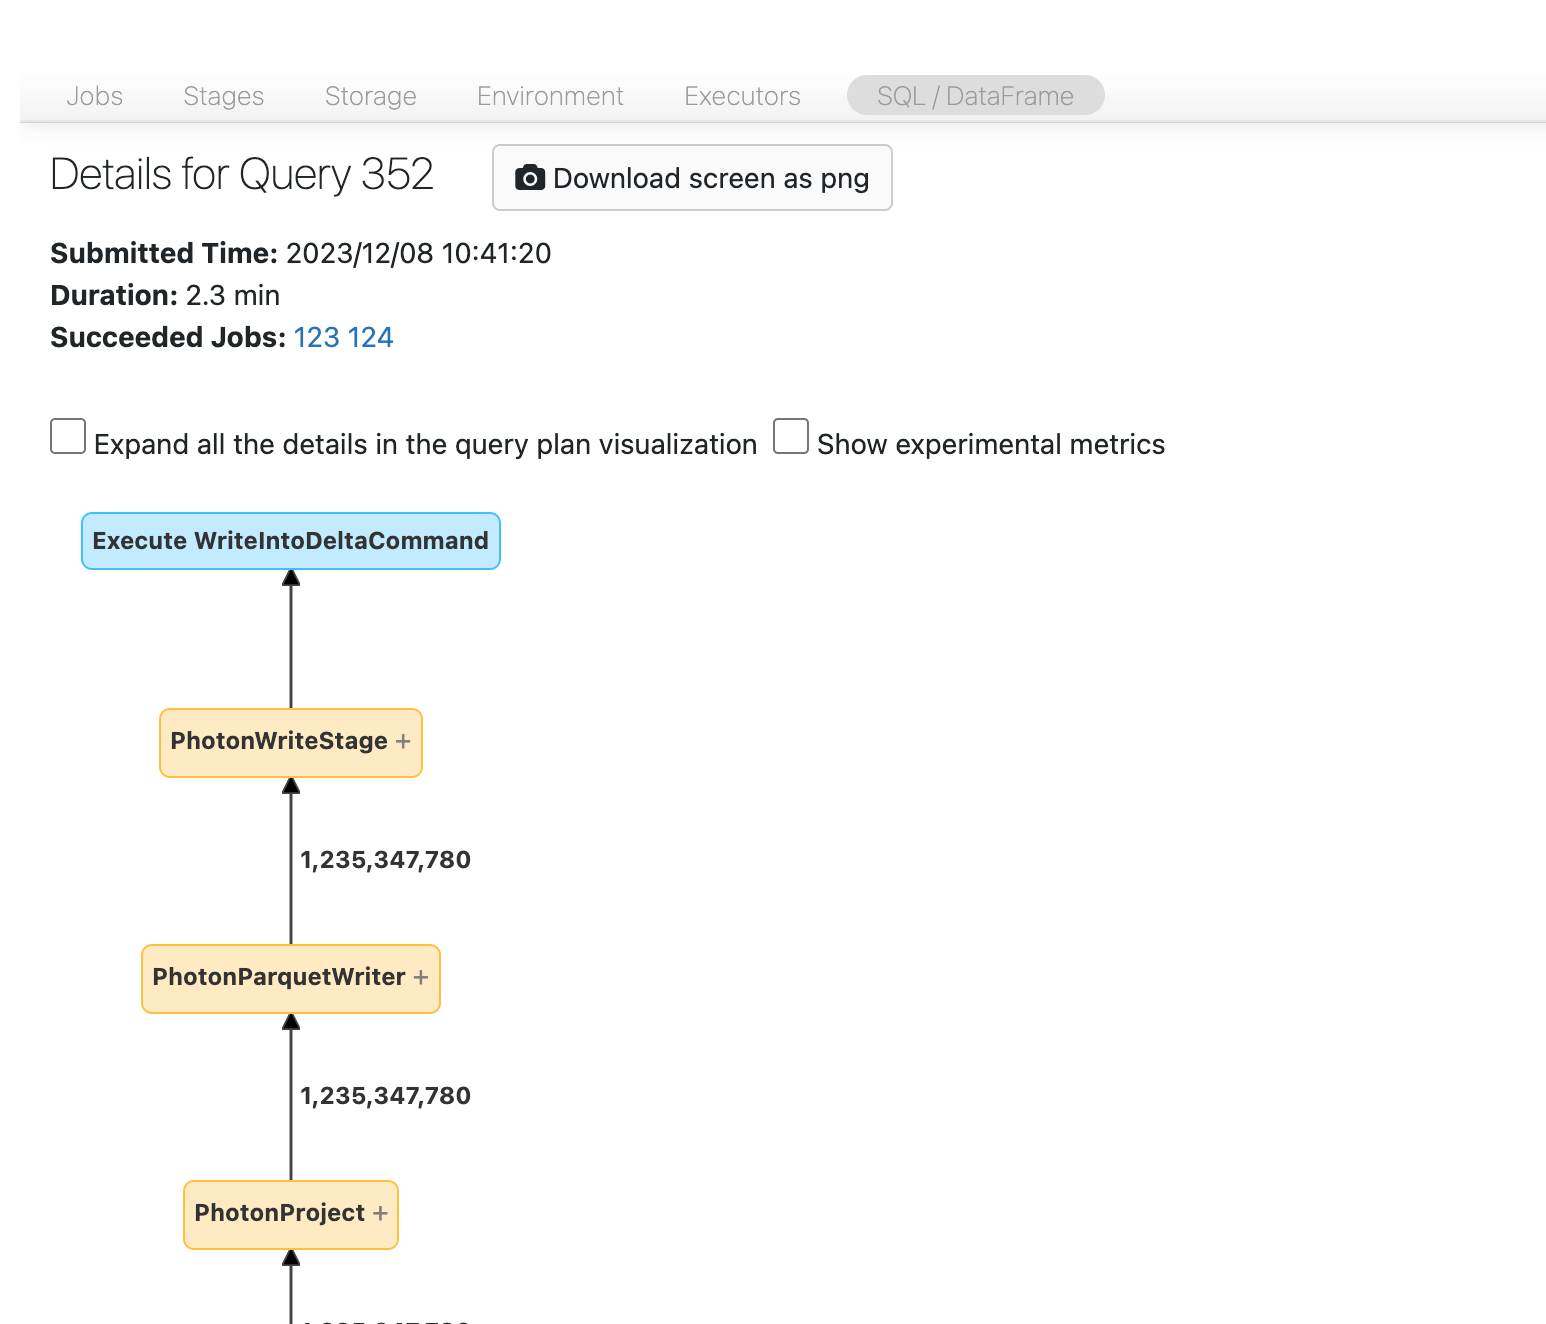
研究DAG,找出时间花在哪里。 有些节点会直接显示其持续时间。 例如,该节点显示时长为 2.1 分钟,并包含阶段 ID:
其他节点只有点击后才显示持续时间。 在这个例子中,写入节点的持续时间为1.4分钟:
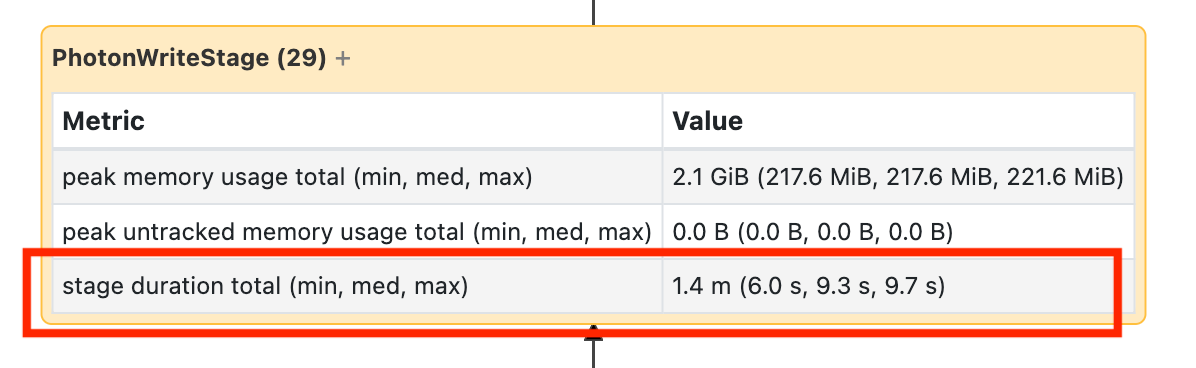
这些时间是累计的,代表所有任务的执行时间总和,而非实际经过的挂钟时间。 它们与已用时间和成本相关。
点击操作符查看输出行、峰值内存和溢出大小等指标。 有关 Spark 报告的操作员指标定义,请参见 Apache Spark 网页界面文档中的 SQL 指标 。
读取大量小文件
如果扫描算子占用了大部分时间,点击它并检查读取的文件数:
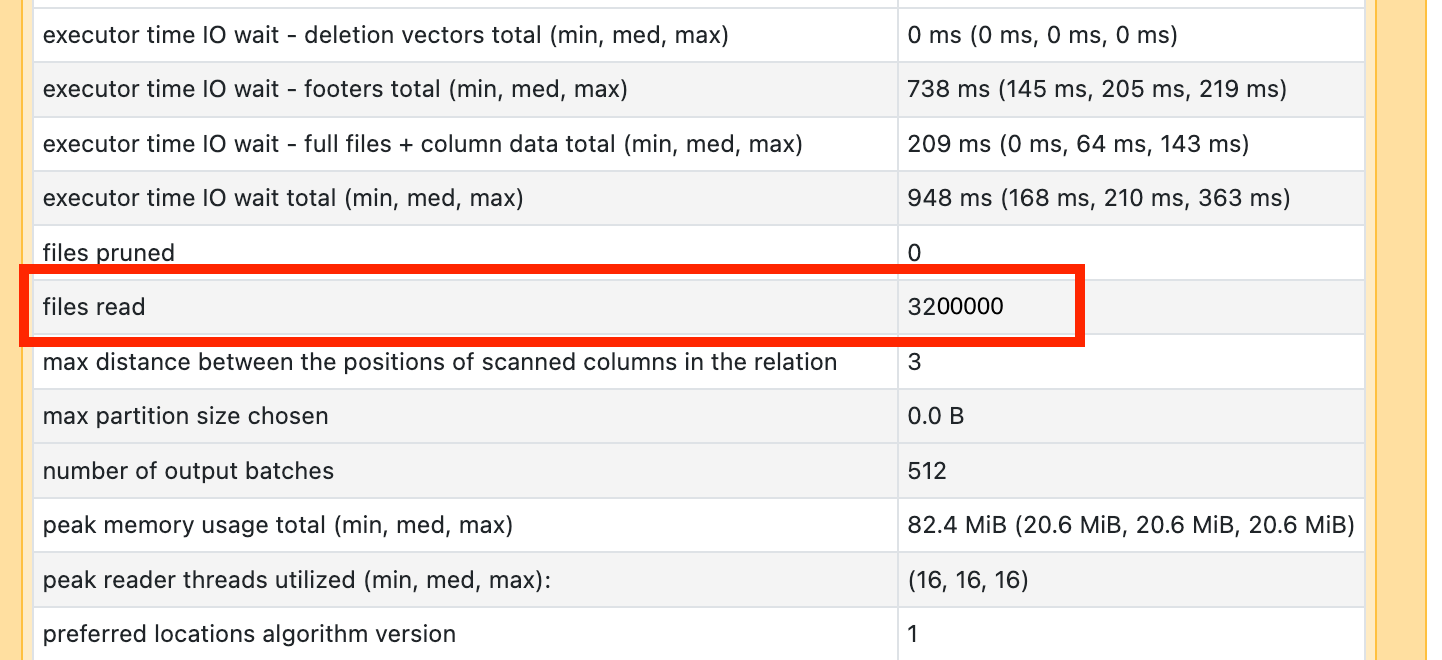
如果查询读取数万个甚至更多文件,表可能存在一个小文件问题。 文件大小至少应为8MB。 在过多列上进行分区,或按高基数列分区,通常会导致产生大量小文件。
运行 OPTIMIZE 可能会有所帮助。 Databricks 还建议启用预测优化并重新考虑文件布局。
编写大量小文件
如果写操作占用了大部分时间,点击它查看写入的文件和数据数量:
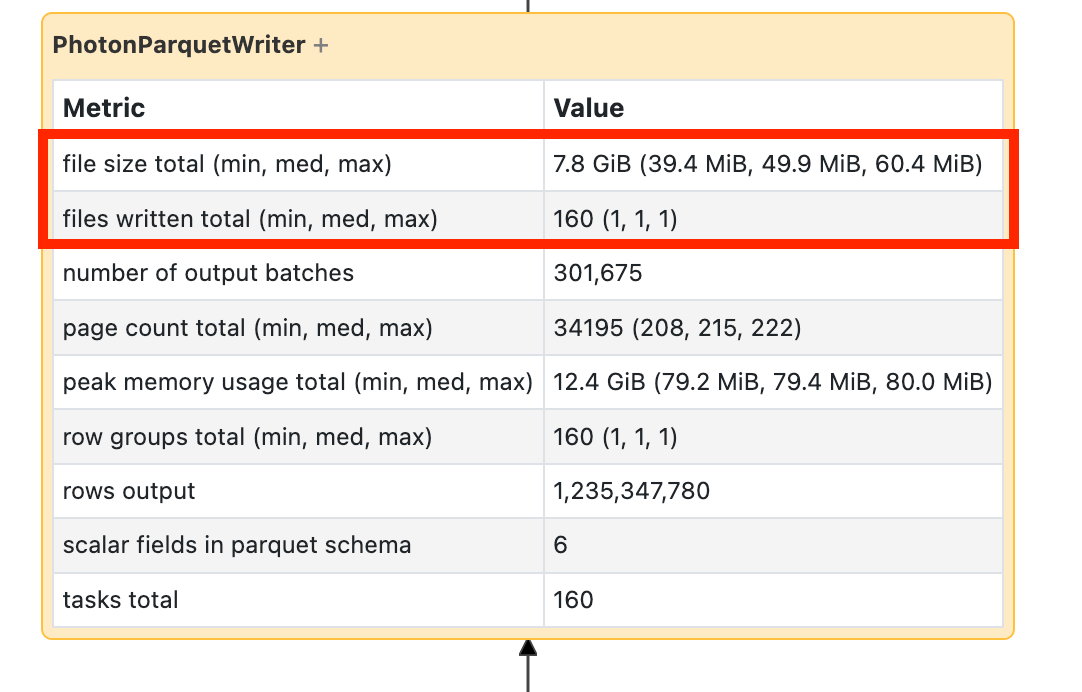
如果查询写入了数万个或更多文件,表可能会有小文件问题。 文件大小至少应为8MB。 在过多列上进行分区,或在高基数列上进行分区,通常会导致产生大量小文件。 启用预测优化、重新考虑文件布局或打开 优化写入。
慢 UDF
如果查询包含 UDF 或像这样的DAG节点,UDF可能是瓶颈:
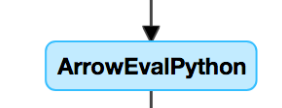
要验证,可以将 UDF 注释掉并观察流水线速度。 如果 UDF 是瓶颈,尽量用原生函数重写它。 如果不能重写,可以查看运行UDF的任务数量。 如果该阶段的任务数少于集群的核心数,请在应用 UDF 之前对数据帧执行 repartition():
  (df
    .repartition(num_cores)
    .withColumn('new_col', udf(...))
  )
UDF也可能导致内存问题。 每个任务可能会将其分区内的所有数据加载到内存中。 如果数据过大,查询可能会变慢或不稳定。 重新分区在这里也很有帮助,因为它让每个任务都变小了。
笛卡尔联接
笛卡尔连接和嵌套循环连接成本很高。 如果DAG中出现了一个,请确认其为有意为之并考虑替代方案。 如果连接条件是区间中的点或区间重叠条件,请参见 范围连接优化。
分解联接或分解
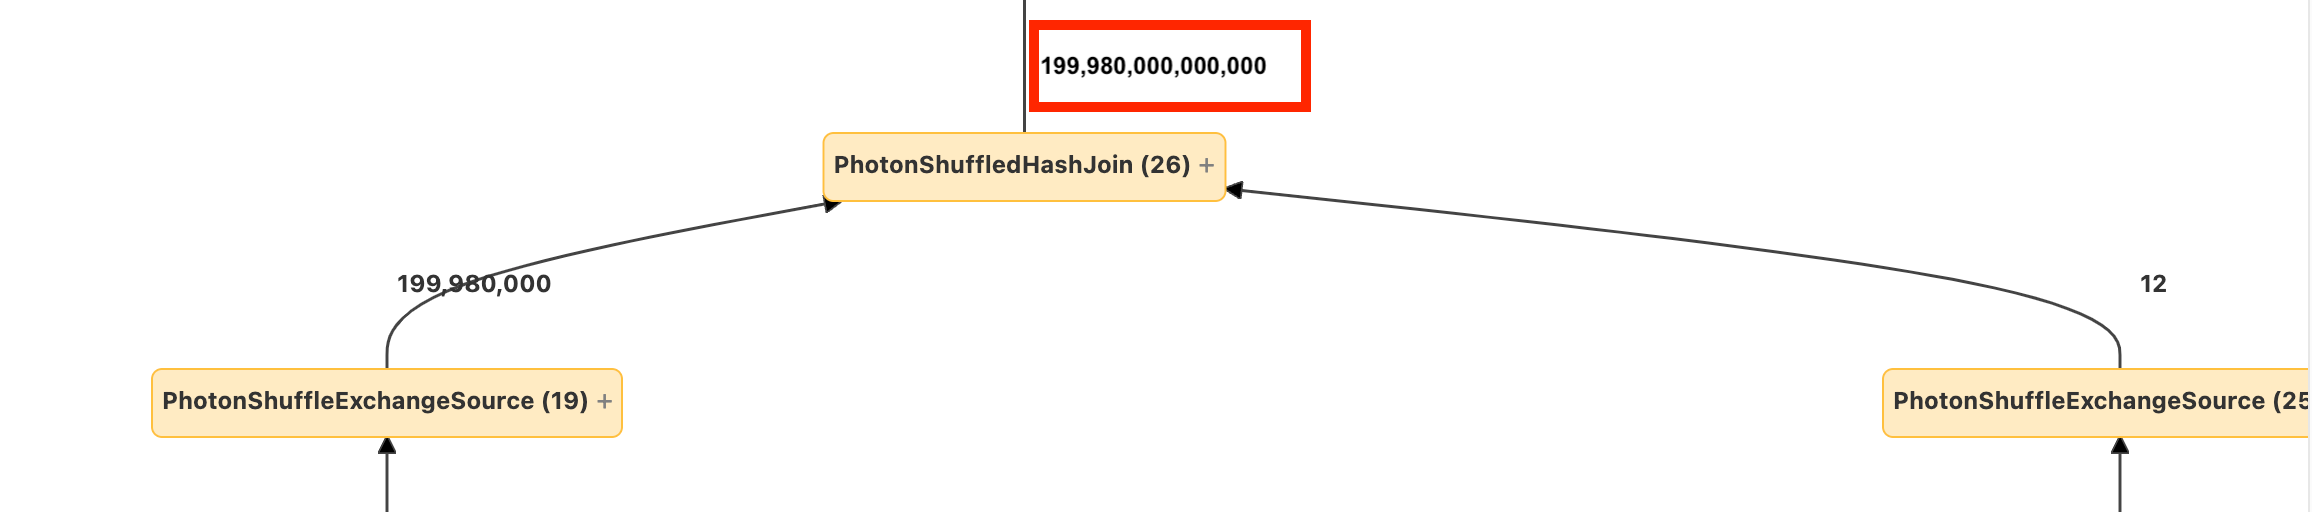
如果 DAG 节点显示输入行数较少而输出行数要多得多,则原因可能是爆炸式联接或 explode():