本页提供了用于管理各种用户界面、工具、库和语言的 Unity 目录 卷 中的文件的示例。
注释
现已推出 Beta 版,可使用 FILE 类型将卷中的文件用作表中的值,并对这些文件应用表访问控制。 参见 文件类型和非结构化数据。
Databricks 建议使用卷来管理对云对象存储中非表格数据的所有访问,以及存储工作负荷支持文件。 示例包括:
用于引入的数据文件,例如 CSV、JSON 和 Parquet
用于数据科学、ML 和 AI 工作负载的文本、图像和音频文件
Azure Databricks 写出的 CSV 或 JSON 工件用于与外部系统集成
库、初始化脚本和构建产物
卷提供可移植操作系统接口(POSIX)样式的路径,这些路径能够与基于用户空间文件系统(FUSE)的工具和框架一起使用。 这使得它们非常适合需要 POSIX 样式访问的机器学习框架和开放源代码 Python模块。 有关 URI 方案、POSIX 路径及其与卷的关系的详细信息,请参阅是否需要提供用于访问数据的 URI 方案?
管理卷中的文件的方法
有关每个方法的快速示例,请参阅 在 Unity Catalog 卷中处理文件。
| 接口 | Description |
|---|---|
| 目录资源管理器 UI | 通过Azure Databricks工作区进行交互式文件管理 |
| 编程访问 | 使用 Apache Spark、Pandas 或 SQL 读取和写入文件 |
| Databricks 工具 | 在笔记本中使用 dbutils.fs 或 magic 命令(%fs, %sh)进行文件操作 |
| 列表和查询文件 | 使用 READ_FILES 和筛选属性查询文件元数据 |
| SQL 命令 | 使用 SQL 关键字(LIST、PUT INTO、GET、REMOVE)和连接器的文件操作 |
| Databricks CLI | 使用 databricks fs 命令的命令行操作 |
| SDK | 使用 Python、Java 或 Go SDK 的文件操作 |
| REST API | 自定义集成的直接 API 访问 |
使用目录浏览器
目录资源管理器提供了选项以执行与存储在 Unity Catalog 卷内的文件有关的常见文件管理任务。
若要与卷中的文件交互,请执行以下操作:
在Azure Databricks工作区中,单击
 Catalog。
搜索或浏览要使用的卷并将其选中。
有关创建和管理卷的详细信息,请参阅 创建和管理 Unity 目录卷。
将文件上传到卷
可以将任何格式的文件(包括结构化、半结构化或非结构化)上传到卷。 卷可以支持由基础云存储支持的最大文件大小。 但是,通过 Azure Databricks UI 将文件上传到卷时,文件大小限制为 5 GB。 若要上传大于 5 GB 的文件,请使用 Databricks SDK for Python。 有关详细信息,请参阅 管理 Unity 目录卷中的文件。
要求
在上传到卷之前,请确保具有以下各项:
启用了 Unity Catalog 的工作区
WRITE VOLUME在目标卷上USE SCHEMA在父模式上USE CATALOG在父目录集上
有关详细信息,请参阅 Unity Catalog 权限参考。
上传步骤
在边栏中,单击“ 新建”,然后单击 “添加或上传数据”。
单击“ 将文件上传到卷”。
在 “文件”下,单击 “浏览 ”或“将文件拖放到放置区域”。
在目标卷下,选择卷或目录,或粘贴卷路径。
如果目标架构中不存在卷,可以通过单击“ 创建卷”来创建卷。 在卷中,可以创建新目录。
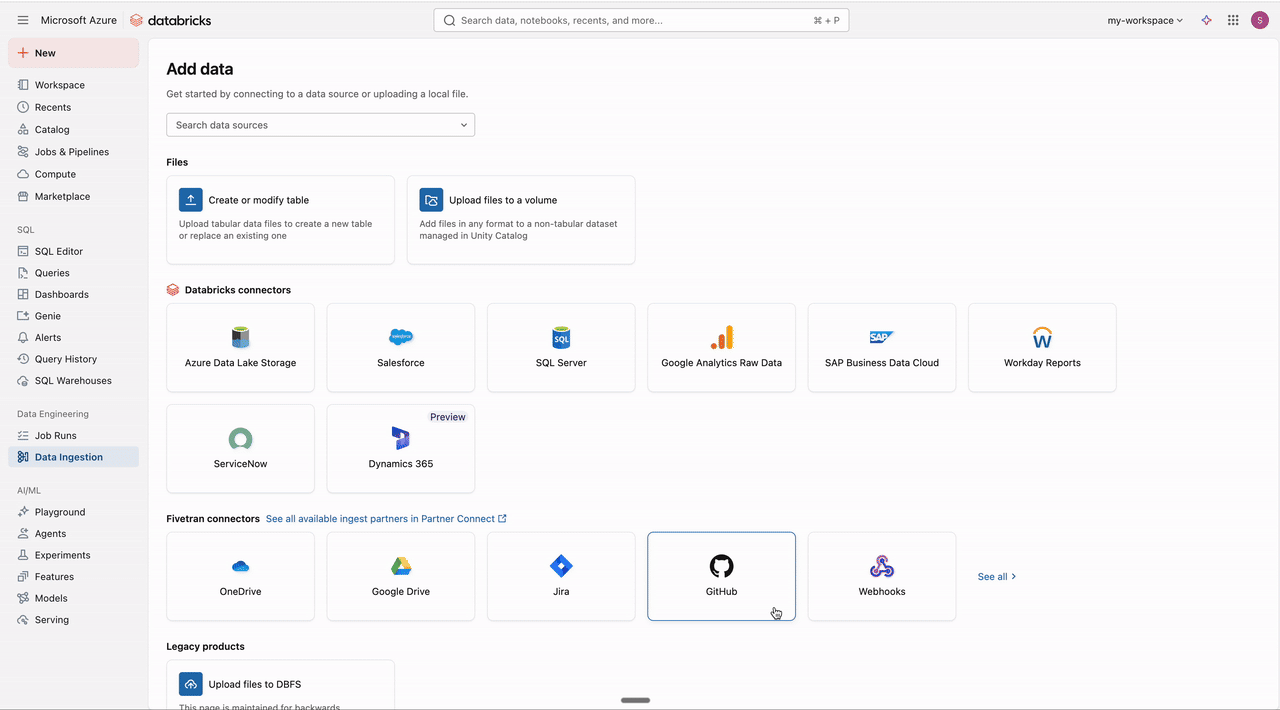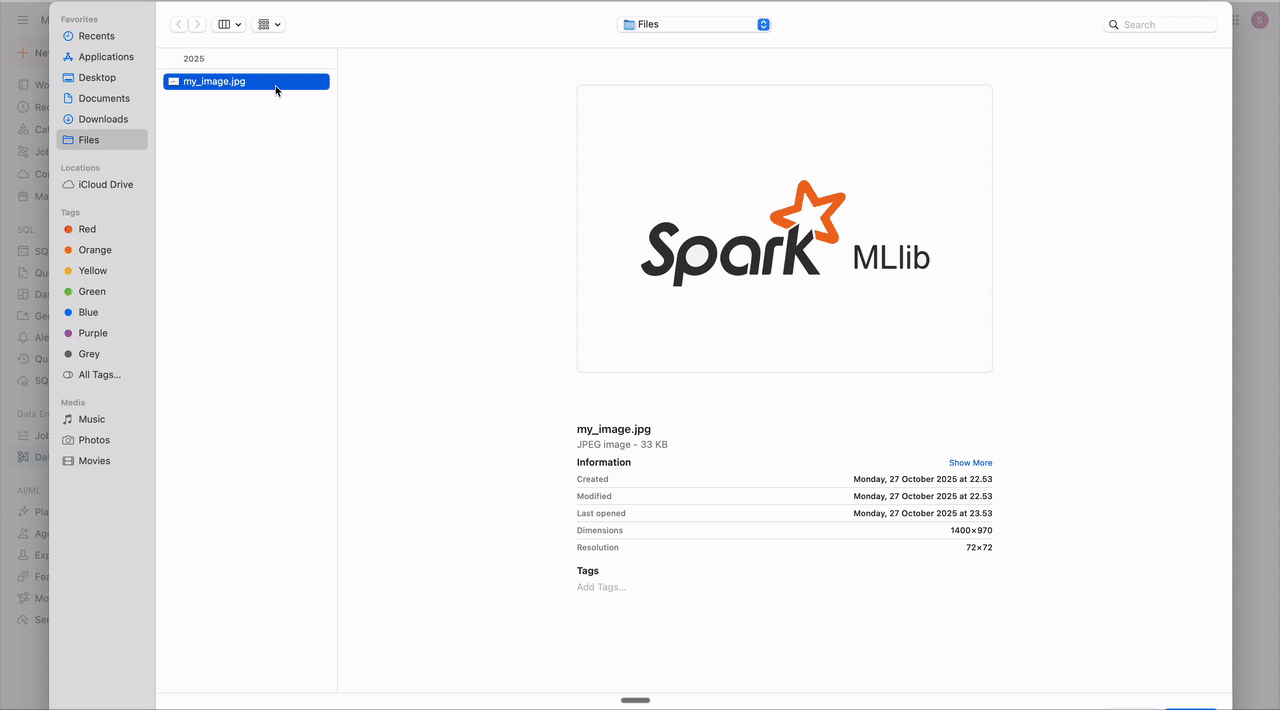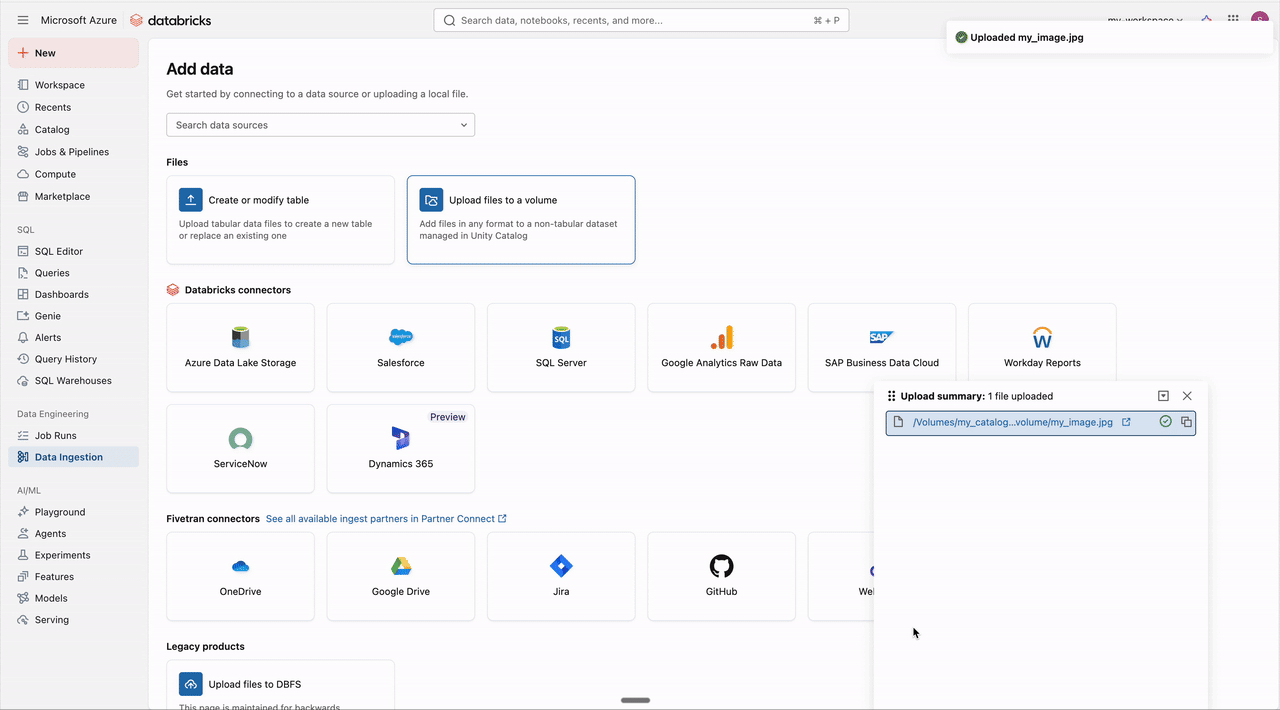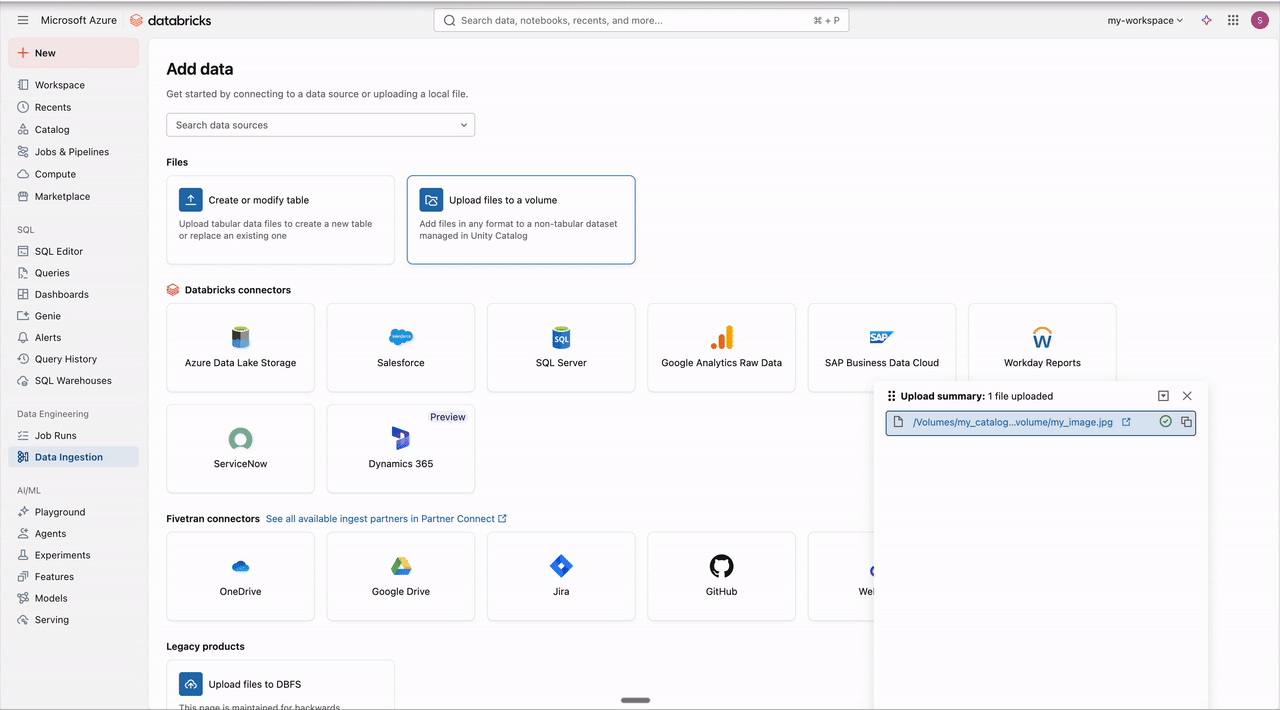
还可以通过以下方式访问上传 UI:
在目录资源管理器中: 向卷添加数据>上传文件
从笔记本: 文件>将文件上传到卷
后续步骤
上传到卷后,可以执行以下操作:
从文件创建 Unity 目录托管表。 请参阅 从卷中的数据创建表。
在机器学习和数据科学工作负载中使用文件
使用上传的文件,配置群集库、笔记本限定的库或作业依赖项。
- 在作业中设置文件到达触发器
编辑卷中的文件
你可以在 Azure Databricks 文件编辑器中打开存储在卷中的文本文件,并在原地编辑,而无需下载文件并重新上传。 编辑器会自动把你的更改保存到卷里。
要在编辑器中打开文件,你需要以下权限:
READ VOLUME在卷上USE SCHEMA在父模式上在父目录上单击
USE CATALOG在该卷上
WRITE VOLUME以保存更改。 有关详细信息,请参阅 Unity Catalog 权限参考。
要编辑卷中的文件:
在目录资源管理器中,浏览包含该文件的卷。
点击文件名旁边的
 竖排省略号菜单,然后点击在编辑器中打开。
你也可以点击文件名打开其预览,然后点击
 ,再点击 在编辑器中打开。
编辑文件。 编辑器会自动把你的更改保存到卷里。
你也可以在笔记本或 SQL 编辑器中打开卷文件。 在 架构浏览器中,将鼠标悬停在文件上,点击 竖排省略号菜单,然后点击 打开文件。
如果文件在编辑器外发生变化,编辑器会显示 “检测到冲突” 对话框。 点击 “是”,我想获取最新更改 以加载该文件的最新版本,或者点击 “否”,覆盖内容 以用你的版本覆盖其内容。
支持的文件类型
编辑器会打开以下扩展名的文件:
文本文件:txt、log、md
代码文件:py, scala, sql, r, sh
半结构化数据文件:json, ndjson, jsonl, csv, tsv, tab
配置文件: yaml, yml, toml, ini, conf, properties, env
名为 stdout 或 stderr 的文件也会在编辑器中打开。
Limitations
编辑器有以下限制:
如果文件大于10 MB,你无法在编辑器中打开它。 要编辑文件,下载后本地编辑,然后再上传。
如果文件的扩展名不在前一个列表中,比如图片、PDF或Parquet文件,你就无法在编辑器中打开它。 你仍然可以预览支持的格式,如图片、PDF和Parquet文件。 请参阅预览卷中的文件。
- 文件编辑器在由世纪互联运营的 Azure 中不可用,在由世纪互联运营的 Azure 区域中也不可用。
从卷中下载文件
若要从卷下载文件,请执行以下操作:
选择一个或多个文件。
单击“下载”以下载这些文件。
删除卷中的文件
若要删除卷中的文件,请执行以下操作:
选择一个或多个文件。
单击 “删除” 。
单击“删除”,在出现的对话框中确认删除。
创建空目录
若要在卷中创建新目录,请执行以下操作:
在“卷概述”选项卡上,单击“ 创建目录”。
输入目录名称。
单击 “创建” 。
下载一个目录
在卷中要下载一个目录时,请执行以下操作:
单击
目录右侧的 kebab 菜单。单击“ 下载目录”。
目录以 ZIP 文件的形式下载。
从卷中删除目录
若要从卷中删除目录,请执行以下操作:
选择一个或多个目录。
单击 “删除” 。
单击“删除”,在出现的对话框中确认删除。
卷的 UI 文件管理任务
点击文件名旁边的更多菜单,以执行以下操作:
在编辑器中打开(仅支持文本文件)。 参见 编辑卷中的文件。
复制路径
下载文件
删除文件
创建表
从数据卷创建表格
Azure Databricks提供一个用户界面,用于从存储在 Unity Catalog 存储卷中的文件或目录创建 Unity Catalog 管理表。
必须在目标架构中具有 CREATE TABLE 权限,并且有权访问正在运行的 SQL 仓库。
选择一个或多个文件或一个目录。 文件应该具有相同的数据布局。
单击“创建表”。 此时会显示“从卷创建表”对话框。
使用提供的对话框查看数据预览并完成以下配置:
选择“创建新表”或“覆盖现有表”
选择目标目录和架构。
指定表名称。
(可选)替代默认列名和类型,或选择排除列。
注释
单击“高级属性”可查看其他选项。
单击“创建表”以创建具有指定属性的表。 完成后,目录资源管理器会显示表详细信息。
以编程方式处理卷中的文件
使用以下格式从所有受支持的语言和工作区编辑器中读取和写入卷中的文件:
/Volumes/catalog_name/schema_name/volume_name/path/to/files
您与卷中的文件交互的方式与在任何云对象存储位置交互文件的方式相同。 这意味着,如果当前管理使用云 URI、DBFS 装载路径或 DBFS 根路径来与数据或文件交互的代码,则可以更新代码以改用卷。
注释
卷仅用于非表格数据。 Databricks 建议使用 Unity Catalog 表注册表格数据,然后使用表名读取和写入数据。
在卷中读取和写入数据
使用 Apache Spark、pandas、Spark SQL 和其他 OSS 库来读取和写入大量数据文件。
以下示例演示如何读取存储在卷中的 CSV 文件:
Python
df = spark.read.format("csv").load("/Volumes/catalog_name/schema_name/volume_name/data.csv")

display(df)
Pandas
import pandas as pd

df = pd.read_csv('/Volumes/catalog_name/schema_name/volume_name/data.csv')

display(df)
SQL
SELECT * FROM csv.`/Volumes/catalog_name/schema_name/volume_name/data.csv`
针对卷中文件的实用程序命令
Databricks 提供了以下工具来管理磁盘卷中的文件:
Databricks 实用程序中的
dbutils.fs子模块。 请参阅文件系统实用工具 (dbutils.fs)。%fsmagic 是dbutils.fs的别名。%shmagic,它允许针对卷执行 bash 命令。
有关使用这些工具从 Internet 下载文件、解压缩文件和将文件从临时块存储移动到卷的示例,请参阅从 Internet 下载数据。
还可以对文件实用工具命令(如 Python os 模块)使用 OSS 包,如以下示例所示:
import os

os.mkdir('/Volumes/catalog_name/schema_name/volume_name/directory_name')
卷内的数据帧检查点
可以使用 Unity 目录卷路径来存储 数据帧检查点。 数据帧检查点截断数据帧的执行计划,并将内容保存到存储中。 这可以通过在重用 DataFrame 时防止过度长的世系来提高迭代算法和复杂查询计划的性能。
在 Unity 目录卷中存储检查点可对检查点数据应用治理和访问控制,从而帮助你远离非托管云存储路径。
要求
Databricks Runtime 18.1 或更高版本。
使用 Unity Catalog 启用的计算功能,并支持专用或标准访问模式。 无服务器计算不支持卷中的数据帧检查点。
配置检查点目录
设置检查点目录的方法取决于您计算设备的访问模式:
专用访问模式
在具有专用访问模式的计算中,请使用 SparkContext.setCheckpointDir:
spark.checkpoint.dir=/Volumes/<catalog>/<schema>/<volume>/checkpoint
标准访问模式
使用标准访问模式的 spark.checkpoint.dir 计算时,请使用 Spark 配置:
spark.conf.set("spark.checkpoint.dir", "/Volumes/<catalog>/<schema>/<volume>/checkpoints")
创建 DataFrame 检查点
配置检查点目录后,用 DataFrame.checkpoint() 截断执行计划并保存数据。
df = spark.range(100).withColumn("doubled", col("id") * 2)
checkpointed_df = df.checkpoint()
注释
DataFrame 检查点与结构化流处理检查点有所不同。 有关在卷中存储流式处理检查点数据的信息,请参阅 结构化流式处理检查点。
使用 SQL 列出和查询卷中的文件
可以使用 read_files 表值函数 SQL 函数列出卷中的文件并查询其元数据。 这对于发现文件、按文件属性筛选和准备文件以使用 AI 函数进行处理非常有用。
使用READ_FILES与format => "binaryFile"一起时,该函数返回具有以下列的表:
path:完整文件路径modificationTime:最后修改时间戳length:文件大小(字节单位)content:原始文件内容作为二进制数据
还可以选择_metadata该列以访问其他文件信息,包括file_path、file_name和file_sizefile_modification_time。
列出卷中的所有文件
以下示例列出卷中的所有文件,不包括二进制内容:
SELECT
  * EXCEPT (content),
  _metadata
FROM read_files(
  "/Volumes/<catalog>/<schema>/<volume>",
  format => "binaryFile"
);
按类型和大小筛选文件
以下示例筛选 20 KB 到 1 MB 之间的图像文件:
SELECT * EXCEPT (content), _metadata
FROM read_files(
  "/Volumes/my_catalog/my_schema/my_volume",
  format => "binaryFile",
  fileNamePattern => "*.{jpg,jpeg,png,JPG,JPEG,PNG}"
)
WHERE _metadata.file_size BETWEEN 20000 AND 1000000;
按修改时间筛选文件
以下示例查找过去一天修改的 PDF 文件:
SELECT * EXCEPT (content), _metadata
FROM read_files(
  "/Volumes/my_catalog/my_schema/my_volume",
  format => "binaryFile",
  fileNamePattern => "*.{pdf,PDF}"
)
WHERE modificationTime >= current_timestamp() - INTERVAL 1 DAY;
使用 AI 函数处理图像
以下示例使用 ai_query 函数函数为图像文件生成说明:
SELECT
  path AS file_path,
  ai_query(
    'system.ai.llama-4-maverick',
    'Describe this image in ten words or less: ',
    files => content
  ) AS result
FROM read_files(
  "/Volumes/my_catalog/my_schema/my_volume",
  format => "binaryFile",
  fileNamePattern => "*.{jpg,jpeg,png}"
)
WHERE _metadata.file_size < 1000000
  AND _metadata.file_name LIKE '%robots%';
使用 AI 函数分析文档
以下示例使用 ai_parse_document 函数函数从 PDF 收据中提取结构化数据:
SELECT
  path AS file_path,
  ai_parse_document(content, map('version', '2.0')) AS result
FROM read_files(
  "/Volumes/main/public/my_files/",
  format => "binaryFile",
  fileNamePattern => "*.{pdf,PDF}"
)
WHERE _metadata.file_name ILIKE '%receipt%';
使用外部工具管理卷内的文件
Databricks 提供了一套工具,用于从本地环境或集成系统以编程方式管理卷中的文件。
卷中文件的 SQL 命令
Azure Databricks支持以下 SQL 关键字来与卷中的文件交互:
在Azure Databricks笔记本和 SQL 查询编辑器中,仅支持 LIST 命令。 其他 SQL 命令(PUT INTO和GETREMOVE)可通过以下 Databricks SQL 连接器和驱动程序获得,这些连接器和驱动程序支持管理卷中的文件:
使用 Databricks CLI 管理数据卷中的文件
使用 databricks fs 子命令。 请参阅 fs 命令组。
注释
Databricks CLI 要求方案 dbfs:/ 位于所有卷路径之前。 例如,dbfs:/Volumes/catalog_name/schema_name/volume_name/path/to/data。
使用 SDK 管理卷中的文件
以下 SDK 支持管理卷中的文件:
用于Python的 Databricks SDK。 使用 WorkspaceClient.files 中的可用方法。 有关示例,请参阅管理 Unity Catalog 卷中的文件。
用于Java的 Databricks SDK。 使用 WorkspaceClient.files 中的可用方法。 有关示例,请参阅管理 Unity Catalog 卷中的文件。
适用于 Go 的 Databricks SDK。 使用 WorkspaceClient.files 中的可用方法。 有关示例,请参阅管理 Unity Catalog 卷中的文件。
使用 REST API 管理卷中的文件
使用文件 API 管理卷中的文件。
卷中文件的 REST API 示例
以下示例使用 curl 和 Files API 3.0 在卷中执行文件管理任务。
Important
文件 API 3.0 目前处于 测试阶段。 要使用它,工作区管理员必须在预览页面开启带有大文件上传支持的文件 API V3。 请参阅 Manage Azure Databricks 预览版。
-
REGIONAL_WORKSPACE_HOST是你工作空间的区域主机名。 - 文件API 3.0需要与Azure Databricks及你的存储保持网络连接。
以下示例在指定卷中创建名为 my-folder 的空文件夹。
curl --request PUT "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/directories/Volumes/main/default/my-volume/my-folder/" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}"
以下示例创建一个名为 data.csv 的文件,其中包含卷中指定路径中的指定数据。
curl --request PUT "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/files/Volumes/main/default/my-volume/my-folder/data.csv?overwrite=true" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}" \
--header "Content-Type: application/octet-stream" \
--data-binary $'id,Text\n1,Hello World!'
以下示例列出指定路径中卷的内容。 此示例使用 jq 设置响应正文 JSON 的格式,以便于阅读。
curl --request GET "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/directories/Volumes/main/default/my-volume/" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq .
以下示例列出指定路径中一个卷上的文件夹内容。 此示例使用 jq 设置响应正文 JSON 的格式,以便于阅读。
curl --request GET "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/directories/Volumes/main/default/my-volume/my-folder" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}" | jq .
以下示例显示存储卷中指定路径下文件的内容。
curl --request GET "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/files/Volumes/main/default/my-volume/my-folder/data.csv" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}"
以下示例从卷中删除指定路径中的文件。
curl --request DELETE "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/files/Volumes/main/default/my-volume/my-folder/data.csv" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}"
以下示例删除指定卷中的文件夹。
curl --request DELETE "https://${REGIONAL_WORKSPACE_HOST}/api/3.0/fs/directories/Volumes/main/default/my-volume/my-folder/" \
--header "Authorization: Bearer ${DATABRICKS_TOKEN}"
在卷中操作或使用文件的限制
在处理卷内的文件之前,请考虑以下限制:
不支持直接追加或非顺序(随机)写入。 这会影响写入 Zip 和Excel文件等操作。 对于这些工作负载:
首先对本地磁盘执行操作
将结果复制到该卷
例如:
# python
import xlsxwriter
from shutil import copyfile

workbook = xlsxwriter.Workbook('/local_disk0/tmp/excel.xlsx')
worksheet = workbook.add_worksheet()
worksheet.write(0, 0, "Key")
worksheet.write(0, 1, "Value")
workbook.close()

copyfile('/local_disk0/tmp/excel.xlsx', '/Volumes/my_catalog/my_schema/my_volume/excel.xlsx')
目录资源管理器无法预览大于 1 MB 或使用 ZIP64 格式的电子表格文件(xls、xlsx)。 请参阅预览卷中的文件。
不支持稀疏文件。 若要复制稀疏文件,请使用
cp --sparse=never:$ cp sparse.file /Volumes/my_catalog/my_schema/my_volume/sparse.file error writing '/dbfs/sparse.file': Operation not supported $ cp --sparse=never sparse.file /Volumes/my_catalog/my_schema/my_volume/sparse.file