输入验证 是用于保护主查询逻辑免受格式不正确或意外事件的方法。 查询升级为显式处理并检查记录,以便它们无法中断主逻辑。
为了实现输入验证,我们将两个初始步骤添加到查询。 我们首先确保提交到核心业务逻辑的架构符合其预期。 然后,我们对异常进行分类处理,并可选择将无效记录路由到次要输出。
具有输入验证的查询的结构如下:
WITH preProcessingStage AS (
	SELECT
		-- Rename incoming fields, used for audit and debugging
		field1 AS in_field1,
		field2 AS in_field2,
		...

		-- Try casting fields in their expected type
		TRY_CAST(field1 AS bigint) as field1,
		TRY_CAST(field2 AS array) as field2,
		...

	FROM myInput TIMESTAMP BY myTimestamp
),

triagedOK AS (
	SELECT -- Only fields in their new expected type
		field1,
		field2,
		...
	FROM preProcessingStage
	WHERE ( ... ) -- Clauses make sure that the core business logic expectations are satisfied
),

triagedOut AS (
	SELECT -- All fields to ease diagnostic
		*
	FROM preProcessingStage
	WHERE NOT (...) -- Same clauses as triagedOK, opposed with NOT
)

-- Core business logic
SELECT
	...
INTO myOutput
FROM triagedOK
...

-- Audit output. For human review, correction, and manual re-insertion downstream
SELECT
	*
INTO BlobOutput -- To a storage adapter that doesn't require strong typing, here blob/adls
FROM triagedOut
若要查看使用输入验证设置的查询的综合示例,请参阅以下部分: 使用输入验证的查询示例。
本文演示如何实现此技术。
背景
Azure 流分析(ASA)作业处理来自流的数据。 流是传输序列化的原始数据的序列(CSV、JSON、AVRO...)。若要从流中读取,应用程序需要知道使用的特定序列化格式。 在 ASA 中,配置流式输入时必须定义事件序列化格式。
反序列化数据后, 需要应用架构来赋予它意义。 这里所说的模式,是指流中的字段列表及每个字段对应的数据类型。 使用 ASA 时,不需要在输入级别设置传入数据的架构。 ASA 转而原生支持动态输入架构。 它期望 字段列表(列)及其类型在事件(行)之间更改。 ASA 还会在未显式提供数据类型时推断数据类型,并在需要时尝试进行隐式类型转换。
动态架构处理 是一项功能强大的功能,是流处理的关键。 数据流通常包含来自多个源的数据,其中包含多个事件类型,每个事件类型都具有唯一架构。 若要对此类流中的事件进行路由、筛选和处理,ASA 必须接收所有这些事件,无论其架构如何。
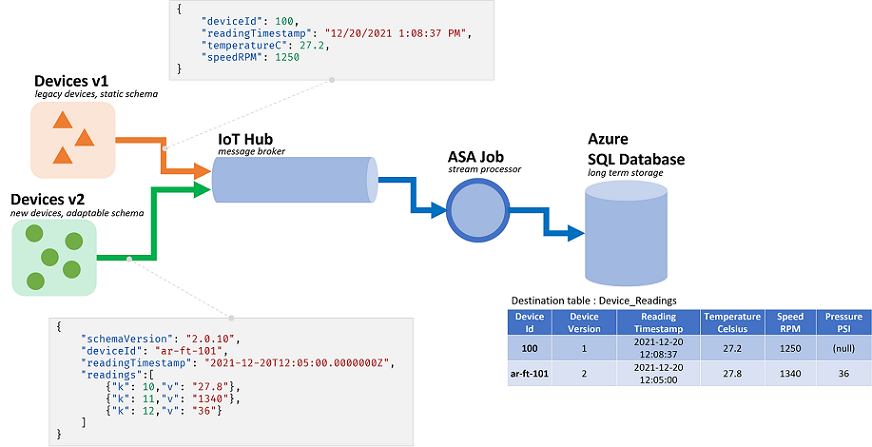
但是,动态架构处理提供的功能具有潜在的缺点。 意外事件可以流经主查询逻辑并中断它。 例如,我们可以在类型的NVARCHAR(MAX)字段中使用 ROUND。 ASA 会将其隐式转换为浮点类型,以匹配 ROUND 的签名。 在此,我们期望或希望此字段始终包含数值。 但是,当我们收到字段设置为 "NaN"的事件时,或者如果字段完全缺失,则作业可能会失败。
借助输入验证,我们在查询中添加预处理步骤,以处理此类格式错误的事件。 我们主要使用 WITH 并 TRY_CAST 来实现它。
场景:针对不可靠事件生产者的输入验证
我们将生成一个新的 ASA 作业,用于从单个事件中心引入数据。 与大多数情况下一样,我们不负责数据生成者。 在这里,生产者是由多家硬件供应商销售的物联网设备。
与利益干系人会面时,我们同意序列化格式和架构。 所有设备都将此类消息推送到通用事件中心,这是 ASA 作业的输入。
模式契约定义如下:
| 字段名称 | 字段类型 | 字段说明 |
|---|---|---|
deviceId |
Integer | 唯一设备标识符 |
readingTimestamp |
日期时间 | 由中央网关生成的消息时间 |
readingStr |
String | |
readingNum |
Numeric | |
readingArray |
字符串数组 |
这又提供了 JSON 序列化下的示例消息:
{
    "deviceId" : 1,
    "readingTimestamp" : "2021-12-10T10:00:00",
    "readingStr" : "A String",
    "readingNum" : 1.7,
    "readingArray" : ["A","B"]
}
我们已经可以看到 架构协定与其实现之间存在差异。 在 JSON 格式中,日期时间没有数据类型。 它将作为字符串传输(见上图 readingTimestamp )。 ASA 可以轻松解决这个问题,但这也表明有必要验证类型并进行显式类型转换。 对于序列化为 CSV 格式的数据,这一点尤其如此,因为所有值随后都会以字符串形式传输。
还有另一个差异。 ASA 使用其自身的类型系统,该系统与传入的类型系统不匹配。 如果 ASA 具有整数(bigint)、日期时间、字符串(nvarchar(max)和数组的 内置类型 ,则它仅支持通过浮点数进行数值。 对于大多数应用程序来说,这种不匹配并不是问题。 但在某些边缘情况下,它可能会导致精度略有偏差。 在这种情况下,我们会在新字段中将数值转换为字符串。 然后,在下游,我们将使用支持固定小数的系统来检测和更正潜在的偏移。
回到我们的查询,这里我们打算:
- 将
readingStr传递给 JavaScript UDF - 计算数组中的记录数
- 将
readingNum四舍五入到小数点后两位 - 将数据插入 SQL 表
目标 SQL 表具有以下架构:
CREATE TABLE [dbo].[readings](
    [Device_Id] int NULL,
    [Reading_Timestamp] datetime2(7) NULL,
    [Reading_String] nvarchar(200) NULL,
    [Reading_Num] decimal(18,2) NULL,
    [Array_Count] int NULL
) ON [PRIMARY]
一个良好的做法是梳理每个字段在任务处理过程中会发生什么变化:
| 领域 | 输入(JSON) | 继承类型(ASA) | 输出(Azure SQL) | 注释 |
|---|---|---|---|---|
deviceId |
number | bigint | 整数 | |
readingTimestamp |
字符串 | nvarchar(MAX) | datetime2 | |
readingStr |
字符串 | nvarchar(MAX) | nvarchar(200) | 供 UDF 使用 |
readingNum |
number | float | 十进制(18,2) | 要舍入 |
readingArray |
array(string) | nvarchar(MAX) 数组 | 整数 | 要计数 |
先决条件
我们将使用 ASA 工具扩展在Visual Studio Code中开发查询。 本教程的第一步将指导你安装所需的组件。
在 VS Code 中,我们将使用本地运行和本地输入/输出,以避免产生任何费用,并加快调试迭代速度。 我们不需要设置事件中心或Azure SQL 数据库。
基本查询
让我们从基本实现开始, 无需输入验证。 我们将在下一部分添加它。
在 VS Code 中,我们将 创建新的 ASA 项目
在 input 文件夹中,我们将创建一个新的 JSON 文件, data_readings.json 并向其添加以下记录:
[
    {
        "deviceId" : 1,
        "readingTimestamp" : "2021-12-10T10:00:00",
        "readingStr" : "A String",
        "readingNum" : 1.7145,
        "readingArray" : ["A","B"]
    },
    {
        "deviceId" : 2,
        "readingTimestamp" : "2021-12-10T10:01:00",
        "readingStr" : "Another String",
        "readingNum" : 2.378,
        "readingArray" : ["C"]
    },
    {
        "deviceId" : 3,
        "readingTimestamp" : "2021-12-10T10:01:20",
        "readingStr" : "A Third String",
        "readingNum" : -4.85436,
        "readingArray" : ["D","E","F"]
    },
    {
        "deviceId" : 4,
        "readingTimestamp" : "2021-12-10T10:02:10",
        "readingStr" : "A Forth String",
        "readingNum" : 1.2126,
        "readingArray" : ["G","G"]
    }
]
然后,我们将 定义一个本地输入,称为 readings引用上面创建的 JSON 文件。
配置后,它应如下所示:
{
    "InputAlias": "readings",
    "Type": "Data Stream",
    "Format": "Json",
    "FilePath": "data_readings.json",
    "ScriptType": "InputMock"
}
通过 预览数据,我们可以观察到记录已正确加载。
我们将通过右键单击Functions文件夹并选择ASA: Add Function来创建新的 JavaScript UDFudfLen。 我们将使用的代码是:
// Sample UDF that returns the length of a string for demonstration only: LEN will return the same thing in ASAQL
function main(arg1) {
    return arg1.length;
}
在本地 运行中,我们不需要定义输出。 我们甚至不需要使用 INTO ,除非有多个输出。 在 .asaql 文件中,我们可以通过以下方式替换现有查询:
SELECT
	r.deviceId,
	r.readingTimestamp,
	SUBSTRING(r.readingStr,1,200) AS readingStr,
	ROUND(r.readingNum,2) AS readingNum,
	COUNT(a.ArrayValue) AS arrayCount
FROM readings AS r TIMESTAMP BY r.readingTimestamp
CROSS APPLY GetArrayElements(r.readingArray) AS a
WHERE UDF.udfLen(r.readingStr) >= 2
GROUP BY
	System.Timestamp(), --snapshot window
	r.deviceId,
	r.readingTimestamp,
	r.readingStr,
	r.readingNum
让我们快速浏览我们提交的查询:
- 若要计算每个数组中的记录数,首先需要解压缩这些记录。 我们将使用 CROSS APPLY 和 GetArrayElements()(更多示例见此处)
- 我们还必须
GROUP BY所有字段,并将它们全部投影到SELECT中。 显式投影字段是一种很好的做法,因为SELECT *会使错误从输入传递到输出- 如果我们定义时间范围,则可能需要使用 TIMESTAMP BY 定义时间戳。 这里我们的逻辑不需要起作用。 对于本地运行,如果不使用
TIMESTAMP BY,所有记录都会加载到同一个时间戳,即运行开始时间。
- 如果我们定义时间范围,则可能需要使用 TIMESTAMP BY 定义时间戳。 这里我们的逻辑不需要起作用。 对于本地运行,如果不使用
- 我们使用 UDF 来筛选
readingStr少于两个字符的读取结果。 我们应该在此处使用 LEN 。 我们使用 UDF 仅用于演示
我们可以 启动运行 并观察正在处理的数据:
| deviceId | readingTimestamp | readingStr | readingNum | arrayCount |
|---|---|---|---|---|
| 1 | 2021-12-10T10:00:00 | 字符串 | 1.71 | 2 |
| 2 | 2021-12-10T10:01:00 | 另一个字符串 | 2.38 | 1 |
| 3 | 2021-12-10T10:01:20 | 第三个字符串 | -4.85 | 3 |
| 1 | 2021-12-10T10:02:10 | 一个 Forth 字符串 | 1.21 | 2 |
现在,我们知道查询正在运行,接下来让我们针对更多数据进行测试。 让我们用以下记录替换 data_readings.json 的内容:
[
    {
        "deviceId" : 1,
        "readingTimestamp" : "2021-12-10T10:00:00",
        "readingStr" : "A String",
        "readingNum" : 1.7145,
        "readingArray" : ["A","B"]
    },
    {
        "deviceId" : 2,
        "readingTimestamp" : "2021-12-10T10:01:00",
        "readingNum" : 2.378,
        "readingArray" : ["C"]
    },
    {
        "deviceId" : 3,
        "readingTimestamp" : "2021-12-10T10:01:20",
        "readingStr" : "A Third String",
        "readingNum" : "NaN",
        "readingArray" : ["D","E","F"]
    },
    {
        "deviceId" : 4,
        "readingTimestamp" : "2021-12-10T10:02:10",
        "readingStr" : "A Forth String",
        "readingNum" : 1.2126,
        "readingArray" : {}
    }
]
在这里,我们可以看到以下问题:
- 设备 #1 已正确执行所有操作
- 设备 #2 忘记添加
readingStr - 设备 #3 将
NaN作为数字发送 - 设备 #4 发送了空记录而不是数组
现在运行这个任务,结果恐怕不会太好。 我们将收到以下错误消息之一:
设备 2 将提供:
[Error] 12/22/2021 10:05:59 PM : **System Exception** Function 'udflen' resulted in an error: 'TypeError: Unable to get property 'length' of undefined or null reference' Stack: TypeError: Unable to get property 'length' of undefined or null reference at main (Unknown script code:3:5)
[Error] 12/22/2021 10:05:59 PM :    at Microsoft.EventProcessing.HostedRuntimes.JavaScript.JavaScriptHostedFunctionsRuntime.
设备 3 将提供:
[Error] 12/22/2021 9:52:32 PM : **System Exception** The 1st argument of function round has invalid type 'nvarchar(max)'. Only 'bigint', 'float' is allowed.
[Error] 12/22/2021 9:52:32 PM :    at Microsoft.EventProcessing.SteamR.Sql.Runtime.Arithmetics.Round(CompilerPosition pos, Object value, Object length)
设备 4 将为我们提供:
[Error] 12/22/2021 9:50:41 PM : **System Exception** Cannot cast value of type 'record' to type 'array' in expression 'r . readingArray'. At line '9' and column '30'. TRY_CAST function can be used to handle values with unexpected type.
[Error] 12/22/2021 9:50:41 PM :    at Microsoft.EventProcessing.SteamR.Sql.Runtime.Cast.ToArray(CompilerPosition pos, Object value, Boolean isUserCast)
每次允许格式不正确的记录从输入流向主查询逻辑,而无需进行验证。 现在,我们认识到输入验证的价值。
实现输入验证
让我们扩展查询以验证输入。
输入验证的第一步是定义核心业务逻辑的架构预期。 回顾原始要求,我们的主要逻辑是:
- 将
readingStr传递给 JavaScript UDF 以测量其长度 - 计算数组中的记录数
- 将
readingNum四舍五入到小数点后两位 - 将数据插入 SQL 表
对于每个点,我们可以列出预期:
- UDF 需要一个 string 类型的参数(此处为 nvarchar(max)),且该参数不能为 null。
-
GetArrayElements()需要数组类型的参数或 null 值 -
Round需要 bigint 或 float 类型的参数,或者值为 null 的参数 - 我们不应依赖 ASA 的隐式强制转换,而应自行进行强制转换,并在查询中处理类型冲突
一种方法是调整主要逻辑来处理这些异常。 但在这种情况下,我们相信我们的主要逻辑是完美的。 因此,让我们改为验证传入的数据。
首先,让我们使用 WITH 将输入验证层添加为查询的第一步。 我们将使用 TRY_CAST 将字段转换为其预期类型,并在转换失败时将其 NULL 设置为:
WITH readingsValidated AS (
	SELECT
		-- Rename incoming fields, used for audit and debugging
		deviceId AS in_deviceId,
		readingTimestamp AS in_readingTimestamp,
		readingStr AS in_readingStr,
		readingNum AS in_readingNum,
		readingArray AS in_readingArray,

		-- Try casting fields in their expected type
		TRY_CAST(deviceId AS bigint) as deviceId,
		TRY_CAST(readingTimestamp AS datetime) as readingTimestamp,
		TRY_CAST(readingStr AS nvarchar(max)) as readingStr,
		TRY_CAST(readingNum AS float) as readingNum,
		TRY_CAST(readingArray AS array) as readingArray

	FROM readings TIMESTAMP BY readingTimestamp
)

-- For debugging only
SELECT * FROM readingsValidated
使用我们最后使用的输入文件(即那个有错误的文件)时,此查询将返回以下集合:
| in_deviceId | in_readingTimestamp | in_readingStr | in_readingNum | in_readingArray | deviceId | 读取时间戳 | readingStr | readingNum | readingArray |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 2021-12-10T10:00:00 | 字符串 | 1.7145 | [“A”,“B”] | 1 | 2021-12-10T10:00:00.0000000Z | 字符串 | 1.7145 | [“A”,“B”] |
| 2 | 2021-12-10T10:01:00 | Null | 2.378 | [“C”] | 2 | 2021-12-10T10:01:00.0000000Z | Null | 2.378 | [“C”] |
| 3 | 2021-12-10T10:01:20 | 第三个字符串 | NaN | [“D”,“E”,“F”] | 3 | 2021-12-10T10:01:20.0000000Z | 第三个字符串 | NULL | [“D”,“E”,“F”] |
| 4 | 2021-12-10T10:02:10 | 一个 Forth 字符串 | 1.2126 | {} | 4 | 2021-12-10T10:02:10.0000000Z | 一个 Forth 字符串 | 1.2126 | NULL |
我们已经可以看到,我们的两个错误正在被处理。 我们转换 NaN 并 {} 变成 NULL。 现在,我们确信这些记录将正确插入到目标 SQL 表中。
我们现在必须决定如何解决缺少或无效值的记录。 经过一些讨论,我们决定拒绝空/无效 readingArray 或缺失 readingStr的记录。
因此,我们添加第二层,在验证层和主逻辑之间对记录进行分流:
WITH readingsValidated AS (
	...
),

readingsToBeProcessed AS (
	SELECT
		deviceId,
		readingTimestamp,
		readingStr,
		readingNum,
		readingArray
	FROM readingsValidated
	WHERE
		readingStr IS NOT NULL
	AND readingArray IS NOT NULL
),

readingsToBeRejected AS (
	SELECT
		*
	FROM readingsValidated
	WHERE -- Same clauses as readingsToBeProcessed, opposed with NOT
	NOT (
		readingStr IS NOT NULL
	AND readingArray IS NOT NULL
	)
)

-- For debugging only
SELECT * INTO Debug1 FROM readingsToBeProcessed
SELECT * INTO Debug2 FROM readingsToBeRejected
最好为两个输出编写单个 WHERE 子句,并在第二个子句中使用 NOT (...) 。 这样,就不能从输出和丢失中排除任何记录。
现在,我们得到两个输出。 Debug1 包含将发送到主逻辑的记录:
| deviceId | 读取时间戳 | readingStr | readingNum | readingArray |
|---|---|---|---|---|
| 1 | 2021-12-10T10:00:00.0000000Z | 字符串 | 1.7145 | [“A”,“B”] |
| 3 | 2021-12-10T10:01:20.0000000Z | 第三个字符串 | Null | [“D”,“E”,“F”] |
Debug2 包含将被拒绝的记录:
| in_deviceId | in_readingTimestamp | in_readingStr | in_readingNum | in_readingArray | deviceId | 读取时间戳 | readingStr | readingNum | readingArray |
|---|---|---|---|---|---|---|---|---|---|
| 2 | 2021-12-10T10:01:00 | Null | 2.378 | [“C”] | 2 | 2021-12-10T10:01:00.0000000Z | NULL | 2.378 | [“C”] |
| 4 | 2021-12-10T10:02:10 | 一个 Forth 字符串 | 1.2126 | {} | 4 | 2021-12-10T10:02:10.0000000Z | 一个四分字符串 | 1.2126 | NULL |
最后一步是将主逻辑添加回去。 我们还将添加一个用于收集被拒绝项的输出。 在这里,最好使用不强制键入的输出适配器,例如存储帐户。
可以在最后一节中找到完整的查询。
WITH
readingsValidated AS (...),
readingsToBeProcessed AS (...),
readingsToBeRejected AS (...)

SELECT
	r.deviceId,
	r.readingTimestamp,
	SUBSTRING(r.readingStr,1,200) AS readingStr,
	ROUND(r.readingNum,2) AS readingNum,
	COUNT(a.ArrayValue) AS arrayCount
INTO SQLOutput
FROM readingsToBeProcessed AS r
CROSS APPLY GetArrayElements(r.readingArray) AS a
WHERE UDF.udfLen(r.readingStr) >= 2
GROUP BY
	System.Timestamp(), --snapshot window
	r.deviceId,
	r.readingTimestamp,
	r.readingStr,
	r.readingNum

SELECT
	*
INTO BlobOutput
FROM readingsToBeRejected
这将为 SQLOutput 提供以下设置,且不存在可能的错误:
| deviceId | 读取时间戳 | readingStr | readingNum | readingArray |
|---|---|---|---|---|
| 1 | 2021-12-10T10:00:00.0000000Z | 字符串 | 1.7145 | 2 |
| 3 | 2021-12-10T10:01:20.0000000Z | 第三个字符串 | Null | 3 |
另外两条记录将发送到 BlobOutput 进行人工评审和后期处理。 我们的查询现在是安全的。
使用输入验证的查询示例
WITH readingsValidated AS (
	SELECT
		-- Rename incoming fields, used for audit and debugging
		deviceId AS in_deviceId,
		readingTimestamp AS in_readingTimestamp,
		readingStr AS in_readingStr,
		readingNum AS in_readingNum,
		readingArray AS in_readingArray,

		-- Try casting fields in their expected type
		TRY_CAST(deviceId AS bigint) as deviceId,
		TRY_CAST(readingTimestamp AS datetime) as readingTimestamp,
		TRY_CAST(readingStr AS nvarchar(max)) as readingStr,
		TRY_CAST(readingNum AS float) as readingNum,
		TRY_CAST(readingArray AS array) as readingArray

	FROM readings TIMESTAMP BY readingTimestamp
),

readingsToBeProcessed AS (
	SELECT
		deviceId,
		readingTimestamp,
		readingStr,
		readingNum,
		readingArray
	FROM readingsValidated
	WHERE
		readingStr IS NOT NULL
	AND readingArray IS NOT NULL
),

readingsToBeRejected AS (
	SELECT
		*
	FROM readingsValidated
	WHERE -- Same clauses as readingsToBeProcessed, opposed with NOT
	NOT (
		readingStr IS NOT NULL
	AND readingArray IS NOT NULL
	)
)

-- Core business logic
SELECT
	r.deviceId,
	r.readingTimestamp,
	SUBSTRING(r.readingStr,1,200) AS readingStr,
	ROUND(r.readingNum,2) AS readingNum,
	COUNT(a.ArrayValue) AS arrayCount
INTO SQLOutput
FROM readingsToBeProcessed AS r
CROSS APPLY GetArrayElements(r.readingArray) AS a
WHERE UDF.udfLen(r.readingStr) >= 2
GROUP BY
	System.Timestamp(), --snapshot window
	r.deviceId,
	r.readingTimestamp,
	r.readingStr,
	r.readingNum

-- Rejected output. For human review, correction, and manual re-insertion downstream
SELECT
	*
INTO BlobOutput -- to a storage adapter that doesn't require strong typing, here blob/adls
FROM readingsToBeRejected
扩展输入验证
GetType 可用于显式检查类型。 它与投影中的 CASE 配合良好,或与集合级别的 WHERE 配合良好。
GetType 还可用于针对元数据存储库动态检查传入架构。 可以通过引用数据集加载存储库。
单元测试 是确保查询可复原的一种良好做法。 我们将生成一系列测试,其中包括输入文件及其预期输出。 我们的查询必须与其生成的输出相匹配,才能通过。 在 ASA 中,单元测试是通过 asa-streamanalytics-cicd npm 模块完成的。 应在部署流水线中创建包含各种格式错误事件的测试用例并对其进行测试。
最后,我们可以在 VS Code 中执行一些轻集成测试。 我们可以通过将本地运行输出到实时输出把记录插入 SQL 表中。
获取支持
如需获取进一步的帮助,可前往 Azure 流分析的 Microsoft 问答页面。