Databricks 功能存储集中了机器学习中使用的功能,以便在模型训练和推理期间运行相同的特征计算。 你可以将特征创建为由 Databricks 计算和管理的特征视图,或者创建由你自己填充的特征表。 以下章节涵盖典型工作流程并定义关键术语。
Databricks Feature Store 提供哪些功能?
Feature Store 提供两种方式来创作特征。 两者都生成受 Unity Catalog 治理的功能,可用于批量推理:
关于如何在它们之间做出选择,请参见 选择一种创作策略。
Databricks 特征存储的工作原理是什么?
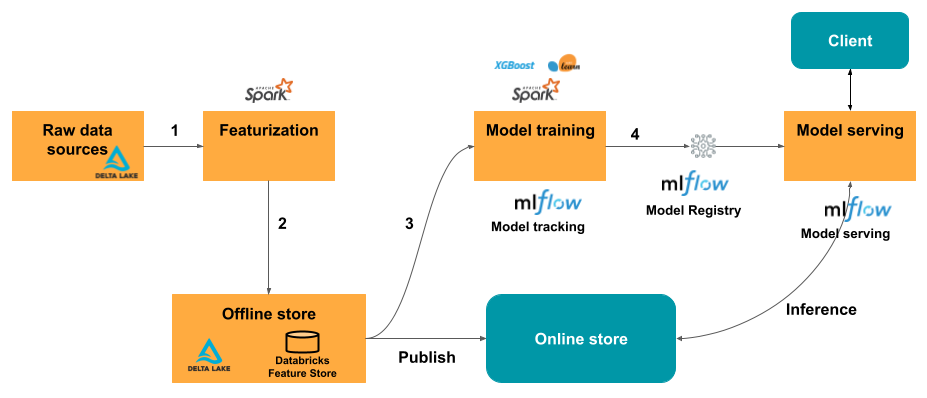
在 Databricks 上使用特征工程的典型机器学习工作流遵循以下路径:
在笔记本中创建原型特征视图,使用 特征工程SDK 生成历史数据和训练集。 并行迭代你的特征定义、数据和模型,直到满意为止。
投入生产:
- 将你的特征注册到 Unity Catalog,使其可治理且可复用。
- 在 MLflow 中训练并记录你的模型,捕获训练所用特征的血缘信息。
- 将你的特征物化到线上或线下存储。
推理:
- 批量时使用
score_batch。 - 对于在线场景,可以为模型或特征建立在线服务端点。
- 批量时使用
特征存储术语表
特征存储
功能存储是一个集中式存储库,使数据科学家能够查找和共享功能。 使用特征库还有助于确保计算特征值的代码在模型训练和推断时保持一致。 你可以以特征视图的形式编写特征,Databricks 会帮你计算和管理,或者以特征表的形式编写特征。 在启用 Unity 目录的工作区中,Unity 目录中的任何包含主键约束的 Delta 表都可以用作特征表。
机器学习使用现有数据生成模型以预测将来的结果。 几乎所有情况下,原始数据都需要预处理和转换,然后才能用于生成模型。 这一过程称为特征工程,其输出称为特征,即模型的构建模块。 使用特征视图时,你用简单的 Python 定义做特征工程,Databricks 会帮你管理这些流水线。
开发特征非常复杂且耗时。 另一个复杂因素是,对于机器学习,需要对模型训练执行特征计算,然后在使用模型进行预测时再次执行。 这些实现可能不是由同一团队或不是使用相同的代码环境完成的,这可能会导致延迟和错误。 此外,组织中的不同团队通常具有类似的特征需求,但可能不知道其他团队所做的工作。 特征存储旨在解决这些问题。
功能视图
特征视图是定义特征的抽象概念。 你定义了一个 Feature View,Databricks 负责计算它。 在训练时,特征工程SDK生成时间点正确的历史特征数据和训练集。 为推理,将该特征 实体化 到相应的在线或离线存储,Databricks 会协调计算,确保特征数据准备好提供。
Feature Views 支持批处理和流式特征,新鲜度从亚秒级到按计划执行的 cron 不等。
特征表
特征表是带有主键的Delta表。 你可以用 publish_table 将功能表同步到在线商店。 特征表元数据用于跟踪生成该表所依据的数据源,以及创建或写入该表的笔记本和作业。
使用 Databricks Runtime 13.3 LTS 及更高版本时,如果工作区已启用 Unity Catalog,可使用 Unity Catalog 中具有主键的任何 Delta 表作为特征表。 请参阅 Unity 目录中的功能表。
特征表中的特征通常是使用通用计算函数来计算和更新的。
可以将特征表发布到联机存储进行实时模型推理。
FeatureLookup
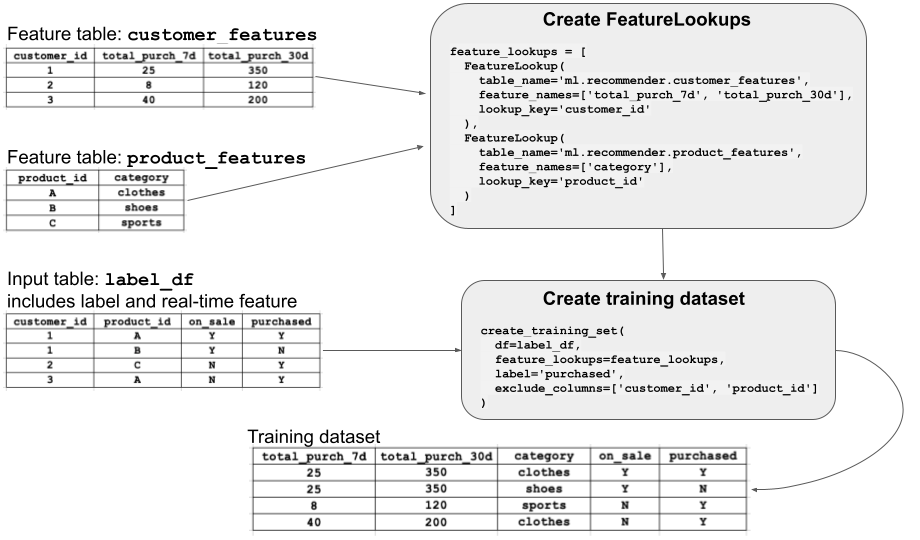
许多不同的模型可能使用特定特征表中的特征,并非所有模型都需要每个特征。 若要使用特征训练模型,请为每个特征表创建 FeatureLookup。
FeatureLookup 指定要从表中使用的特征,并定义用于将特征表联接到传递给 create_training_set 的标签数据的键。
该图说明了 FeatureLookup 的工作原理。 在此示例中,你想要使用两个特征表中的特征(customer_features 和 product_features)来训练模型。 为每个特征表创建一个 FeatureLookup,指定表的名称、要从表中选择的特征(列),以及在联接特征以创建训练数据集时使用的查找键。
然后,调用 create_training_set,如图所示。 此 API 调用指定包含原始训练数据 (label_df)、要使用的 FeatureLookups 和 label(即包含标准答案的列)的数据帧。 训练数据必须包含与特征表的每个主键对应的列。 特征表中的数据通过这些键连接到输入数据帧。 结果以“训练数据集”的形式显示在关系图中。
FeatureFunction
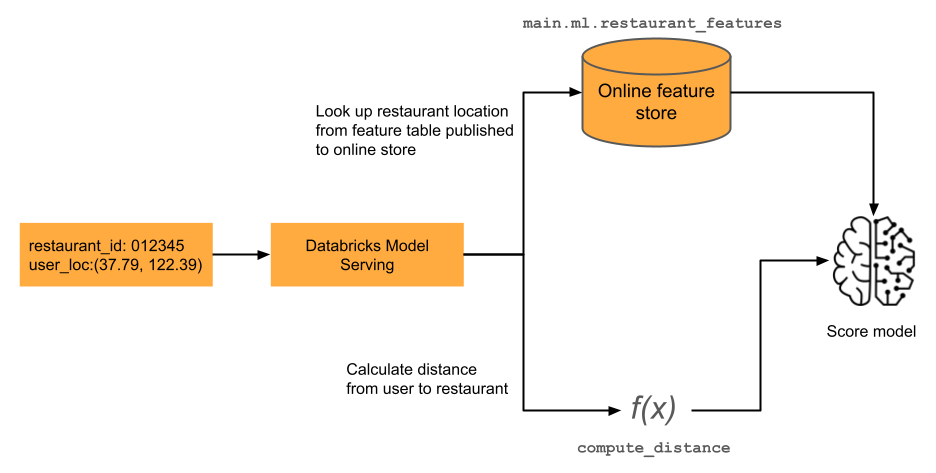
某个特征可能依赖于仅在推理时可用的信息。 你可以指定一个 FeatureFunction,该函数将实时输入与特征值相结合来计算最新的特征值。 下图中显示了一个示例。 有关详细信息,请参阅 按需功能计算。
训练集
训练集包括一个特征列表,以及一个包含原始训练数据、标签和用于查找特征的主键的数据帧。 可以通过指定要从特征存储中提取的特征来创建训练集,并在模型训练期间提供训练集作为输入。
有关如何创建和使用训练集的示例,请参阅创建训练数据集。
使用 Unity Catalog 中的特征工程训练并记录模型时,可以在目录资源管理器中查看模型的世系。 自动跟踪和显示用于创建模型的表和函数。 请参阅特征治理和世系。
FeatureSpec
Unity Catalog 实体 FeatureSpec 定义了一组可重复使用的特性和功能,用于服务。
FeatureSpecs 将特征表中的 FeatureLookups 合并成FeatureFunction单个逻辑单元,该单元可用于模型训练或使用特征服务终结点提供。
FeatureSpecs 由 Unity Catalog 存储和管理,并对其组成的脱机特性表和函数进行完整溯源跟踪。 这可实现跨不同模型和应用程序的治理、可发现性和重用性。
可通过以下方式使用:FeatureSpec
使用 Python API 或 REST API 创建功能服务终结点。 请查看 服务功能表 ,或直接使用模型服务界面部署。 对于高性能应用程序,请启用路由优化。
在模型训练中通过引用
FeatureSpec和create_training_set使用。
FeatureSpec 始终引用脱机特性表,但必须将其发布到在线存储以进行实时服务场景。
时序特征表(时间点查找)
用于训练模型的数据通常内置了时间依赖项。 生成模型时,必须仅考虑观测到的目标值之前的特征值。 如果基于在目标值时间戳之后测量的数据对特征进行训练,模型的性能可能会受影响。
时序功能表包含时间戳列,以确保训练数据集中的每个行表示行时间戳时的最新已知特征值。 只要特征值会不断变化(例如,在使用时序数据、基于事件的数据或时间聚合数据时),就应该使用时序特征表。
创建时序特征表时,可以通过使用timeseries_columns参数(用于 Unity Catalog 中的特征工程)或timestamp_keys参数(用于 Workspace Feature Store),将时间相关的列指定为主键中的时序列。 这样就可以在使用 create_training_set 或 score_batch 时启用时间点查找。 系统使用你指定的 timestamp_lookup_key 执行截至时间戳的联接。
如果不使用 timeseries_columns 参数或 timestamp_keys 参数,并且仅将时序列指定为主键列,则功能存储不会在联接期间将时间点逻辑应用于时序列。 它只匹配具有精确时间匹配项的行,而不匹配时间戳之前的所有行。
线下商店
脱机特征存储用于特征发现、模型训练和批量推理。 它包含具体化为Delta表的特征表。
流媒体
除了批量写入以外,Databricks 特征存储还支持流式处理。 可以将特征值从流式处理源写入特征表,特征计算代码可以利用结构化流式处理将原始数据流转换为特征。
还可以将特征表从脱机数据库实时传输到联机数据库。
模型打包
使用 Unity Catalog 或工作区特征存储中的特征工程训练机器学习模型并使用客户端的 log_model() 方法对其进行记录时,该模型会保留对这些特征的引用。 在推理时,模型可以选择性地自动检索特征值。 调用方只需提供模型中使用的特征的主键(例如 user_id),然后模型将检索全部所需的特征值。
在批量推理中,特征值是从脱机存储中检索的,并在评分之前与新数据相联接。 在实时推理中,特征值从在线商店中检索。
若要使用特征元数据打包模型,请使用 FeatureEngineeringClient.log_model (适用于 Unity Catalog 中的特征工程)或 FeatureStoreClient.log_model(适用于工作区特征存储)。